


+++ term = “Cosa è un crawler dei motori di ricerca?” lastmod = “2026-10-08” title = “Cosa è un crawler dei motori di ricerca?&rdq...
21 min di lettura
Un crawler dei motori di ricerca è un programma automatizzato — chiamato anche web crawler, spider bot o semplicemente bot — che naviga sistematicamente il World Wide Web per scoprire, leggere e raccogliere informazioni dalle pagine web.
La documentazione sui crawler di Google spiega le categorie di crawler e fetcher utilizzate da Google. Utilizza questa documentazione per verificare come un particolare crawler Google accede a un sito web affiliato.
In questa pagina
Un crawler dei motori di ricerca è un programma automatizzato — chiamato anche web crawler, spider bot o semplicemente bot — che naviga sistematicamente il World Wide Web per scoprire, leggere e raccogliere informazioni dalle pagine web. I dati raccolti da un crawler vengono inviati a un motore di ricerca, che li organizza in un enorme database chiamato indice. Quando qualcuno effettua una query di ricerca, il motore estrae i risultati pertinenti da quell’indice, non dal web live.
Il termine “spider” (ragno) deriva dal modo in cui questi programmi navigano nel web: seguono i collegamenti ipertestuali da una pagina all’altra, proprio come un ragno si muove attraverso i fili della sua ragnatela. Il primo crawler noto, WebCrawler, fu lanciato nel 1994 e contribuì a diffondere questa metafora che è rimasta.
Google utilizza Googlebot, Bing utilizza Bingbot ed entrambi sono spider che svolgono la stessa funzione principale.

Configura il tracciamento avanzato in pochi minuti. Nessuna carta di credito richiesta.
Comprendere il processo di scansione aiuta i proprietari di siti a prendere decisioni migliori sulla struttura del sito, la priorità delle pagine e la SEO tecnica.
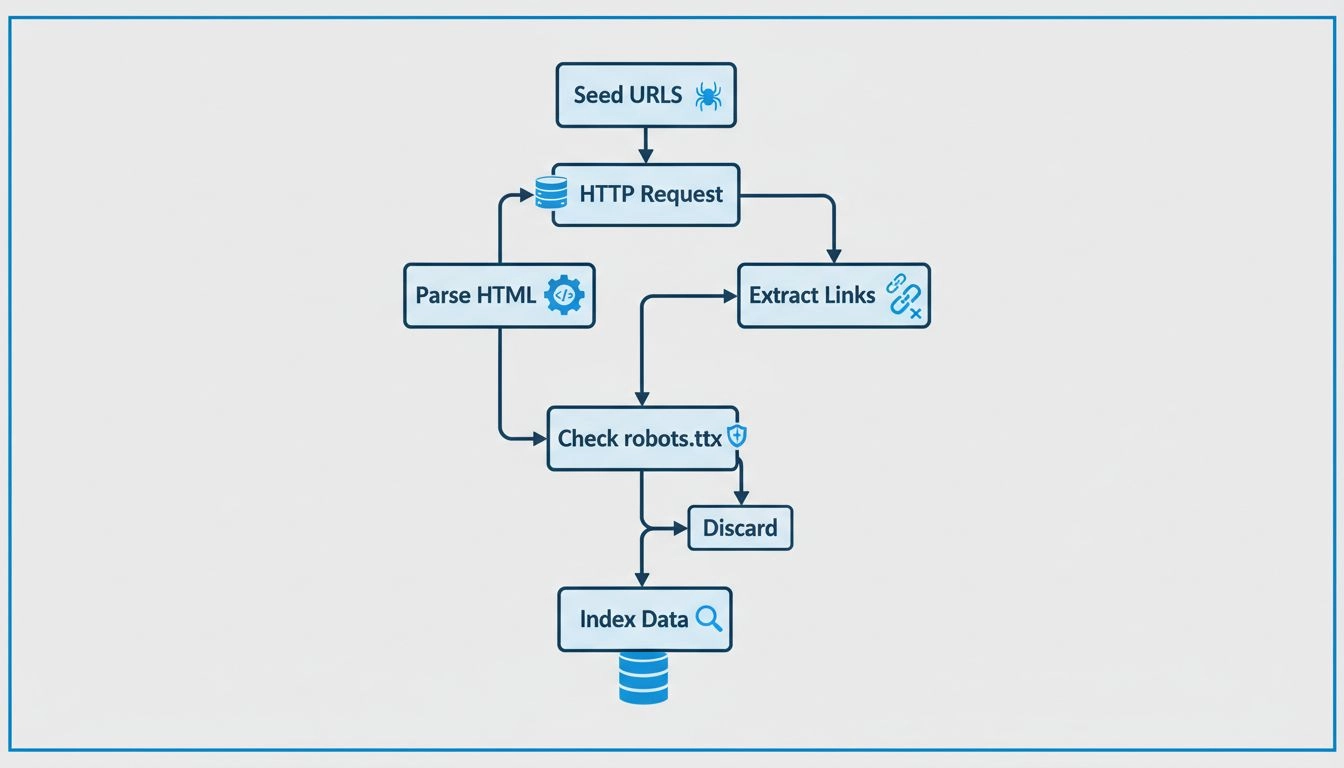
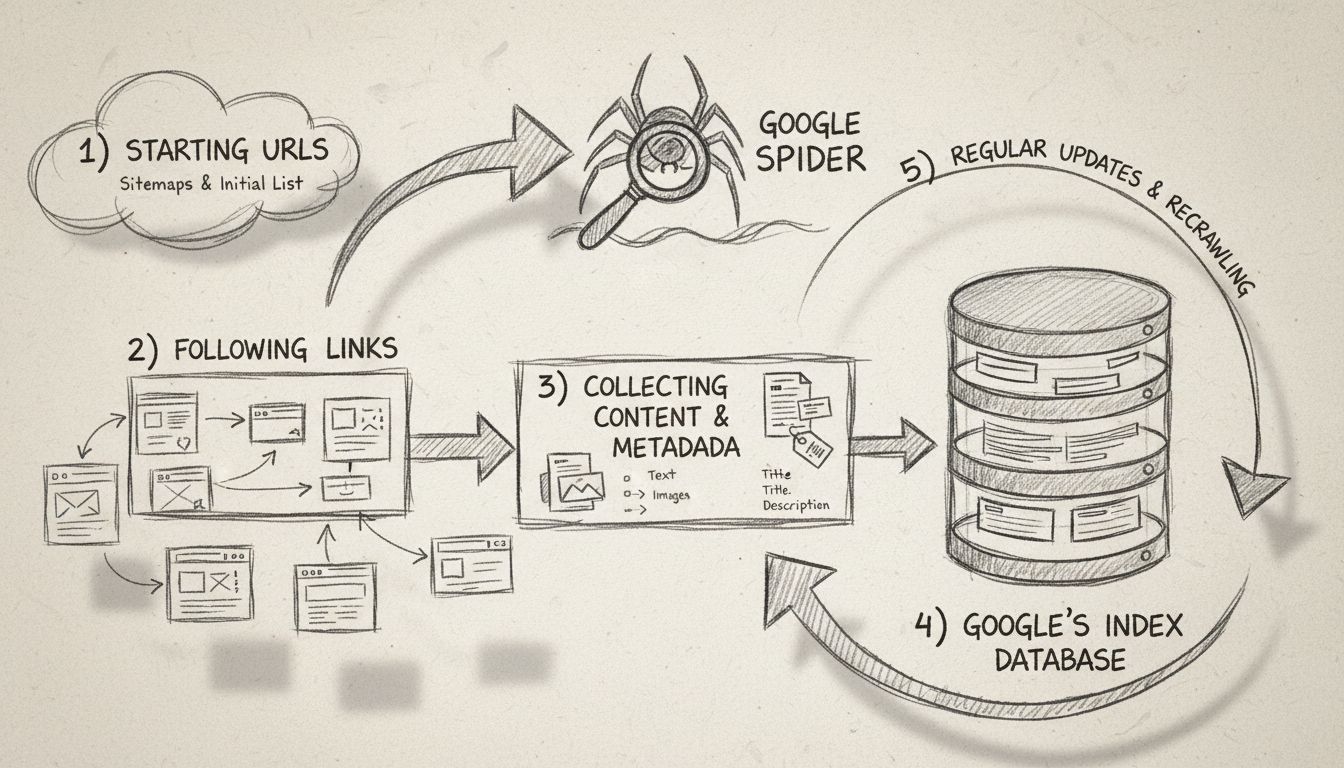
Ogni crawler parte da un elenco di indirizzi web noti chiamati URL seed (semi). Questi possono provenire da pagine già scansionate in precedenza, da sitemap XML inviate o da link scoperti durante scansioni precedenti. Da ogni seed, il crawler scarica la pagina ed estrae tutti i collegamenti ipertestuali che contiene. Quei link formano una coda — talvolta chiamata frontiera di scansione — di pagine da visitare successivamente.
Quando un crawler raggiunge una pagina, esegue tre operazioni:
User-Agent (ad es., Googlebot/2.1).Il processo si svolge in un ciclo continuo:
Un crawler controlla anche il file robots.txt prima di scansionare qualsiasi pagina su un dominio. Se il file non consente un percorso, un crawler ben educato lo salterà. I crawler obbediscono anche ai meta robots tag e alle intestazioni HTTP X-Robots-Tag che impediscono loro di indicizzare una pagina o di seguirne i link.
Ogni motore di ricerca principale gestisce il proprio crawler. Ecco quelli che hanno più probabilità di visitare il tuo sito:
| Nome Crawler | Motore di Ricerca | Token User-Agent |
|---|---|---|
| Googlebot | Googlebot | |
| Bingbot | Bing | Bingbot |
| Slurp Bot | Yahoo (alimentato da Bing) | Slurp |
| DuckDuckBot | DuckDuckGo | DuckDuckBot |
| Baiduspider | Baidu (Cina) | Baiduspider |
| Yandex Bot | Yandex (Russia) | YandexBot |
| Applebot | Apple (Siri, Spotlight) | Applebot |
Googlebot è disponibile in due varianti: un crawler desktop che simula un browser desktop e un crawler mobile che simula uno smartphone. Da quando Google è passato all’indicizzazione mobile-first, il Googlebot mobile è il crawler primario per la stragrande maggioranza dei siti.
Bingbot alimenta l’indice di Bing e fornisce anche risultati a Yahoo e ad altri partner di syndication. DuckDuckBot esegue la scansione per DuckDuckGo, che integra il proprio indice con i risultati di Bing. Baiduspider e Yandex Bot servono rispettivamente i mercati cinese e russo e vale la pena consentirli se hai un pubblico in quelle regioni.
Sii il primo a conoscere le nuove funzionalità e gli aggiornamenti del prodotto.
I crawler dei motori di ricerca possono vedere tutto quanto segue quando visitano una pagina:
I crawler non “vedono” le pagine come farebbe un essere umano. I contenuti incorporati in immagini senza testo alternativo, il testo renderizzato all’interno di JavaScript complessi che non viene eseguito correttamente e i contenuti dietro muri di login o paywall sono invisibili alla maggior parte dei crawler. Anche gli elementi interattivi come moduli, menu a discesa e contenuti a scorrimento infinito che richiedono clic dell’utente potrebbero non essere rilevati, a meno che il sito non utilizzi un rendering lato server o tecniche di rendering dinamico adeguate.
Il crawl budget è il numero di pagine che un crawler dei motori di ricerca esaminerà sul tuo sito in un determinato periodo di tempo. Google determina il crawl budget in base a due fattori:
Per i siti di grandi dimensioni — cataloghi e-commerce, editori di notizie o siti affiliati con migliaia di pagine prodotto — il crawl budget è importante. Se i crawler trascorrono tempo su URL di scarso valore (parametri di filtro, ID di sessione, pagine duplicate), potrebbero non arrivare ai tuoi contenuti importanti prima della chiusura della finestra di scansione.
Hai tre strumenti principali per guidare il comportamento dei crawler.
Un file robots.txt, posizionato alla radice del tuo dominio, indica ai crawler quali parti del tuo sito possono e non possono visitare. Utilizza una sintassi semplice:
User-agent: *
Disallow: /admin/
Disallow: /search/
/admin/ e /search/. Puoi indirizzare crawler specifici utilizzando il loro token user-agent:User-agent: Googlebot
Disallow: /private/
Per il controllo a livello di pagina, utilizza il meta robots tag nell’HTML <head>:
<meta name="robots" content="noindex, nofollow">
X-Robots-Tag), utile per file non HTML come i PDF.Una sitemap XML elenca gli URL che desideri vengano prioritizzati dai crawler. Inviala tramite Google Search Console o Bing Webmaster Tools. Una sitemap non garantisce la scansione, ma aiuta i crawler a scoprire pagine nuove e aggiornate più velocemente — specialmente su siti con architettura profonda o linking interno limitato.
I termini sono spesso confusi, ma descrivono scopi diversi:
| Aspetto | Web Crawler (Spider) | Web Scraper |
|---|---|---|
| Scopo | Scoprire e indicizzare pagine per la ricerca | Estrarre dati specifici dalle pagine |
| Operatore | Motori di ricerca (Google, Bing) | Individui, aziende, ricercatori |
| Ambito | Ampio — l’intero web raggiungibile | Mirato — siti o dati specifici |
| Output | Un indice ricercabile | Dati strutturati (CSV, database, API) |
| Rispetta robots.txt | Sì (quelli legittimi) | Variabile; molti scraper lo ignorano |
Un crawler costruisce la mappa; uno scraper estrae i dati. Entrambi sono automatizzati, ma servono scopi fondamentalmente diversi. Alcuni strumenti, come Screaming Frog SEO Spider, confondono i confini — eseguono la scansione come un crawler ma vengono utilizzati per audit dei siti, non per l’indicizzazione nei motori di ricerca.
Non intrinsecamente. I crawler legittimi dei motori di ricerca sono benefici — senza di loro, il tuo sito non apparirebbe nei risultati di ricerca. Tuttavia, non tutti i bot sono amichevoli.
I segni di attività dannosa dei bot includono:
GPTBot di OpenAI è un web crawler utilizzato per raccogliere dati di training per modelli AI. Non è un crawler per motori di ricerca — non alimenta un indice di ricerca pubblico.
User-agent: GPTBot
Disallow: /
Se sei preoccupato per la privacy, DuckDuckGo e Brave Search sono i due principali motori di ricerca che non tracciano gli utenti né creano profili personali. Entrambi gestiscono i propri crawler (DuckDuckBot e il crawler di Brave) e integrano i propri indici con risultati provenienti da altre fonti. Si basano su parole chiave contestuali piuttosto che sulla cronologia utente per classificare i risultati, il che significa che la SEO on-page del tuo sito conta ancora di più per la visibilità su queste piattaforme.
I crawler dei motori di ricerca influenzano direttamente ogni ruolo nell’ecosistema del marketing di affiliazione.
Le pagine di destinazione del tuo programma di affiliazione, le pagine dei termini e i contenuti promozionali devono essere scansionabili e indicizzabili. Se i crawler non riescono a raggiungere le informazioni sul tuo programma, i potenziali affiliati che cercano “[il tuo brand] programma di affiliazione” potrebbero non trovarti organicamente. Passaggi chiave:
Ogni recensione di prodotto, articolo comparativo e guida che pubblichi dipende dall’essere trovato attraverso la ricerca — e questo significa essere scansionato e indicizzato. I crawler sono i guardiani. Buone pratiche:
lastmod nella tua sitemap può indurre i crawler a rivisitare le tue pagine prima.Comprendere il comportamento dei crawler ti aiuta a supportare meglio i tuoi affiliati:
site:) e se stanno bloccando involontariamente i crawler.Scopri come la comprensione dei crawler web può aiutarti a ottimizzare il tuo sito per migliorare il posizionamento nei motori di ricerca e aumentare le entrate da affiliazione.
+++ term = “Cosa è un crawler dei motori di ricerca?” lastmod = “2026-10-08” title = “Cosa è un crawler dei motori di ricerca?&rdq...
Scopri come funzionano i web crawler, dagli URL seed all'indicizzazione. Comprendi il processo tecnico, i tipi di crawler, le regole del robots.txt e come i cra...
Scopri cos'è lo Spider di Google (Googlebot), come effettua il crawling e l'indicizzazione dei siti web e perché è fondamentale per la SEO. Impara come ottimizz...
Unisciti alla nostra community di clienti soddisfatti e fornisci un eccellente supporto clienti con PostAffiliatePro.


Consenso Cookie
Usiamo i cookie per migliorare la tua esperienza di navigazione e analizzare il nostro traffico. See our privacy policy.