


Crawler dei motori di ricerca
Un crawler dei motori di ricerca è un bot automatizzato che esplora le pagine web per indicizzare i contenuti per motori come Google e Bing. Scopri come funzion...
12 min di lettura
SEO
DigitalMarketing
+3
Un crawler dei motori di ricerca è un programma software automatizzato — chiamato anche bot, spider o spiderbot — che naviga sistematicamente il World Wide Web, scarica il contenuto delle pagine e segue collegamenti ipertestuali per scoprire URL nuovi o aggiornati.
Un crawler dei motori di ricerca è un programma software automatizzato — chiamato anche bot, spider o spiderbot — che naviga sistematicamente il World Wide Web, scarica il contenuto delle pagine e segue collegamenti ipertestuali per scoprire URL nuovi o aggiornati. Il suo compito principale è alimentare l’indice di un motore di ricerca con dati freschi, così quando qualcuno digita una query, il motore può restituire risultati pertinenti e aggiornati. Senza crawler, un motore di ricerca non ha modo di sapere che una pagina esiste.
Il crawler stesso non classifica nulla. Scopre e trasferisce ciò che trova — testo, collegamenti, metadati, immagini — a un sistema separato di indicizzazione e ranking. Scansione, indicizzazione e ranking sono tre fasi distinte. Una pagina può essere scansionata e tuttavia non apparire mai nei risultati di ricerca se non soddisfa le soglie di qualità del motore durante l’indicizzazione.
La documentazione di Google sui crawler distingue i crawler comuni, i crawler per casi speciali e i fetcher attivati dall’utente. Controlla l’identità e il comportamento documentati del crawler pertinente quando indaghi su problemi di accesso.
In questa pagina
Un web crawler opera in un ciclo continuo basato su alcuni passaggi fondamentali. Comprendere questi passaggi aiuta i proprietari di siti web a diagnosticare perché le pagine potrebbero non apparire nei risultati di ricerca — il problema è spesso nella fase di scansione, molto prima che si consideri il ranking.
Ogni crawler inizia con un insieme di URL noti chiamati URL seed. Questi possono provenire da pagine già scansionate in precedenza, sitemap inviate o punti di partenza selezionati manualmente. Il crawler scarica ogni pagina seed, estrae ogni collegamento ipertestuale che trova e aggiunge qualsiasi collegamento non ancora visto a una coda di esecuzione chiamata crawl frontier.
Il ciclo poi si ripete:
Questo ciclo non termina mai veramente. Il web cambia costantemente e nuove pagine appaiono ogni secondo, quindi un crawler lavora semplicemente su ciò che è successivo nella coda, rivisitando le vecchie pagine per verificare eventuali modifiche e aggiungendo URL appena scoperti.
Una volta che un crawler recupera una pagina, ne elabora il rendering — leggendo l’HTML, eseguendo JavaScript dove possibile ed estraendo testo, immagini, metadati e dati strutturati. Poi scarica queste informazioni e le passa all’indicizzatore del motore di ricerca.
Non tutti i crawler gestiscono JavaScript allo stesso modo. Googlebot esegue il rendering di JavaScript e attende i contenuti caricati dinamicamente, ma i crawler di motori di ricerca più piccoli potrebbero leggere solo HTML statico. Ecco perché i siti costruiti interamente con framework JavaScript lato client possono essere invisibili ad alcuni motori di ricerca, a meno che non sia implementato un rendering lato server.
I crawler scoprono nuove pagine attraverso due canali principali:

Configura il tracciamento avanzato in pochi minuti. Nessuna carta di credito richiesta.
I crawler non trattano tutte le pagine allo stesso modo. Operano secondo un insieme di politiche di scansione che determinano quali pagine visitare, in quale ordine e con quale frequenza tornare.
Un crawler deve decidere quali URL prioritizzare dalla sua coda di scansione. I segnali comuni includono:
La frequenza con cui un crawler torna a una pagina dipende dalla frequenza con cui quella pagina cambia. La homepage di un sito di notizie potrebbe essere scansionata ogni pochi minuti. Una pagina statica “Chi Siamo” potrebbe essere rivisitata una volta ogni pochi mesi. I webmaster possono segnalare la frequenza di aggiornamento tramite i tag <changefreq> della sitemap XML, anche se i motori di ricerca trattano questi come suggerimenti, non comandi.
I crawler sono programmati per evitare di sovraccaricare i server web. Rispettano un limite del tasso di scansione — il numero massimo di richieste che invieranno a un singolo sito in un dato periodo. Se un server risponde con errori HTTP come 500 o 503, il crawler arretra per non aggravare il problema. Questo fa parte di ciò che rende il crawling su larga scala una vera sfida ingegneristica.
Il file robots.txt è un documento di testo semplice posizionato nella radice di un dominio che dice ai crawler quali URL possono e non possono richiedere. È lo strumento più importante per gestire l’accesso dei crawler. Una voce robots.txt potrebbe apparire così:
User-agent: Googlebot
Disallow: /private/
Allow: /public/
/private/ ma permette tutto ciò che è sotto /public/. Altri crawler controllano lo stesso file e seguono le proprie direttive User-agent. Vale la pena notare che robots.txt è un protocollo volontario — i crawler ben educati lo rispettano, ma i bot malevoli potrebbero ignorarlo completamente.Il crawl budget è il numero di pagine che un motore di ricerca scansionerà su un sito in un determinato periodo di tempo. È determinato da due fattori:
Per i siti piccoli, il crawl budget è raramente un problema. Per le grandi piattaforme di e-commerce o i siti di contenuti con milioni di URL, gestire il crawl budget diventa essenziale — scansioni sprecate su contenuti duplicati, parametri di navigazione sfaccettata o pagine di scarso valore significano meno risorse per le pagine che contano.
Ogni motore di ricerca principale opera con il proprio crawler, contraddistinto da una stringa user-agent — un identificatore che il bot invia con ogni richiesta HTTP in modo che i server sappiano quale crawler sta visitando.
| Motore di Ricerca | Nome Crawler | Identificativo User-Agent | Scopo |
|---|---|---|---|
| Googlebot | Googlebot/2.1 | Esegue la scansione e indicizza le pagine web per Google Search e altri servizi Google | |
| Bing | Bingbot | Mozilla/5.0 (compatible; bingbot/2.0) | Esegue la scansione e indicizza le pagine per Microsoft Bing |
| DuckDuckGo | DuckDuckBot | DuckDuckBot/1.0 | Esegue la scansione delle pagine per i risultati di ricerca di DuckDuckGo |
| Yandex | YandexBot | Mozilla/5.0 (compatible; YandexBot/3.0) | Esegue la scansione delle pagine per Yandex Search (dominante in Russia) |
| Baidu | Baiduspider | Mozilla/5.0 (compatible; Baiduspider/2.0) | Esegue la scansione delle pagine per Baidu Search (dominante in Cina) |
| Apple | Applebot | Applebot/1.0 | Esegue la scansione delle pagine per Spotlight Search e suggerimenti Siri |
Google gestisce anche crawler specializzati per diversi tipi di contenuto — Googlebot Image esegue la scansione delle immagini, Googlebot Video gestisce i contenuti video, Googlebot News ha come target gli articoli di notizie e AdsBot verifica la qualità delle landing page per Google Ads.
Sii il primo a conoscere le nuove funzionalità e gli aggiornamenti del prodotto.
Identificare se un visitatore è genuinamente Googlebot richiede più della semplice verifica di una stringa user-agent, poiché queste stringhe possono essere falsificate. Per verificare un crawler di Google:
Googlebot.googlebot.com o google.com.Google fornisce documentazione ufficiale che elenca i suoi intervalli IP su google.com/bot.html. Qualsiasi visitatore che afferma di essere Googlebot ma non supera questi passaggi di verifica è un bot falsificato e dovrebbe essere trattato come sospetto.
Sì, ma con limiti. I principali motori di ricerca gestiscono crawler dedicati per contenuti non testuali:
VideoObject per comprendere titolo, descrizione, miniatura e durata.Tuttavia, i crawler non possono “vedere” le immagini come farebbe un essere umano né “guardare” un video. Si affidano interamente a segnali testuali — nomi di file, attributi alt, didascalie, testo circostante del corpo e dati strutturati — per determinare la pertinenza. I contenuti bloccati dietro muri di accesso, paywall o incorporati in complessi player JavaScript potrebbero non essere scansionati affatto.
Questi termini sono spesso usati in modo intercambiabile, ma descrivono cose diverse:
| Aspetto | Web Crawler | Web Scraper |
|---|---|---|
| Scopo | Scoprire e indicizzare URL su tutto il web | Estrarre dati specifici da pagine mirate |
| Ambito | Ampio — segue i collegamenti ovunque | Ristretto — ha come target URL o domini noti |
| Output | Alimenta un indice di ricerca | Produce dati strutturati (CSV, database, foglio di calcolo) |
| Operatore tipico | Motori di ricerca (Google, Bing) | Aziende, ricercatori, analisti di dati |
| Rispetta robots.txt | Sì (crawler legittimi) | Variabile — molti scraper lo ignorano |
| Esempi | Googlebot, Bingbot | Strumenti di monitoraggio prezzi, scraper per generazione lead, collettori di dati per addestramento IA |
I motori di ricerca trovano nuove pagine attraverso diversi canali:
Il percorso più veloce per far scansionare una nuova pagina è inviare il suo URL direttamente tramite Search Console e assicurarsi che sia collegata da una pagina già indicizzata sullo stesso sito.
Non esiste una programmazione fissa. La frequenza di rivisitazione dipende da:
I proprietari del sito possono influenzare la frequenza di rivisitazione pubblicando contenuti regolarmente, mantenendo tempi di risposta rapidi del server e inviando sitemap aggiornate. Ma alla fine, è il crawler a decidere la propria programmazione in base ai segnali che osserva.
I crawler generalmente non possono accedere a:
Un crawler vede solo ciò che è pubblicamente accessibile e collegato. Se una pagina richiede autenticazione o interazione dell’utente per essere visualizzata, è effettivamente invisibile ai motori di ricerca — a meno che il proprietario del sito non conceda esplicitamente l’accesso o fornisca un percorso alternativo, come una sitemap che elenca l’URL combinata con dati strutturati che descrivono il contenuto.
Costruire un crawler che funzioni per poche centinaia di pagine è semplice. Costruirne uno che funzioni per miliardi è un problema completamente diverso. I punti di fallimento comuni includono:
Per la maggior parte delle aziende, gestire un crawler web su larga scala non è pratico senza un’infrastruttura gestita. La decisione di solito si riduce all’utilizzo di uno strumento esistente piuttosto che costruire da zero.
Negli Stati Uniti, il web crawling di pagine pubblicamente accessibili è generalmente legale. Diverse sentenze giudiziarie — incluso hiQ Labs v. LinkedIn — hanno stabilito che la raccolta di dati pubblicamente accessibili non viola le leggi federali.
Tuttavia, la legalità dipende da diversi fattori:
La distinzione tra crawling per indicizzazione di ricerca (ampiamente accettato) e scraping per estrazione di dati commerciali (più contestato legalmente) è importante. La maggior parte dei crawler legittimi dei motori di ricerca opera in un territorio chiaramente legale.
No — ChatGPT stesso non è un web crawler. ChatGPT è un modello di IA conversazionale che genera risposte. Tuttavia, OpenAI gestisce un web crawler separato chiamato GPTBot, che esegue la scansione di pagine web pubbliche per raccogliere dati di addestramento per modelli di IA e per supportare funzionalità di recupero in tempo reale in alcuni prodotti OpenAI.
GPTBot si identifica con il token user-agent GPTBot e rispetta le direttive robots.txt. I proprietari di siti che desiderano bloccare GPTBot specificamente possono aggiungere quanto segue al loro file robots.txt:
User-agent: GPTBot
Disallow: /
I crawler dei motori di ricerca influenzano direttamente tutti nell’ecosistema del marketing affiliato. Se una pagina non viene scansionata, non si posiziona, e se non si posiziona, non genera traffico organico — e nessun guadagno da affiliazione.
Il sito di contenuti di un editore vive o muore in base alla crawlability. Ogni recensione di prodotto, guida comparativa o raccolta di offerte deve essere scopribile dai crawler. Gli errori comuni degli editori che bloccano la scansione includono:
Gli editori dovrebbero verificare che le loro pagine più preziose appaiano nel rapporto di copertura dell’indice di Google Search Console e che nessun tag noindex o regola robots.txt le blocchi involontariamente.
Un inserzionista che gestisce un programma di affiliazione ha bisogno che le proprie pagine prodotto vengano scansionate e indicizzate in modo che gli editori possano collegarsi a pagine live e visibili. Se le pagine prodotto di un commerciante non sono nell’indice di Google, gli editori non hanno dove inviare traffico. I rischi specifici includono:
I commercianti dovrebbero mantenere strutture URL pulite, inviare sitemap dei prodotti e monitorare le statistiche di scansione in Search Console per individuare i problemi prima che influenzino i partner editori.
I program manager si trovano tra commercianti ed editori e dovrebbero comprendere il comportamento dei crawler per risolvere i problemi di visibilità. Quando un editore segnala che la pagina prodotto di un commerciante “non appare su Google”, il problema è spesso un problema di scansione o indicizzazione — non di ranking. I passaggi pratici includono:
site: di Google.Un program manager in grado di diagnosticare problemi di base di scansione aggiunge valore diretto a entrambi i lati della relazione di affiliazione — aiutando i commercianti a risolvere problemi tecnici e aiutando gli editori a confermare che le pagine che promuovono sono trovate.
Scopri come comprendere e ottimizzare i crawler può aumentare la visibilità del tuo sito web e il posizionamento nei motori di ricerca.
Un crawler dei motori di ricerca è un bot automatizzato che esplora le pagine web per indicizzare i contenuti per motori come Google e Bing. Scopri come funzion...
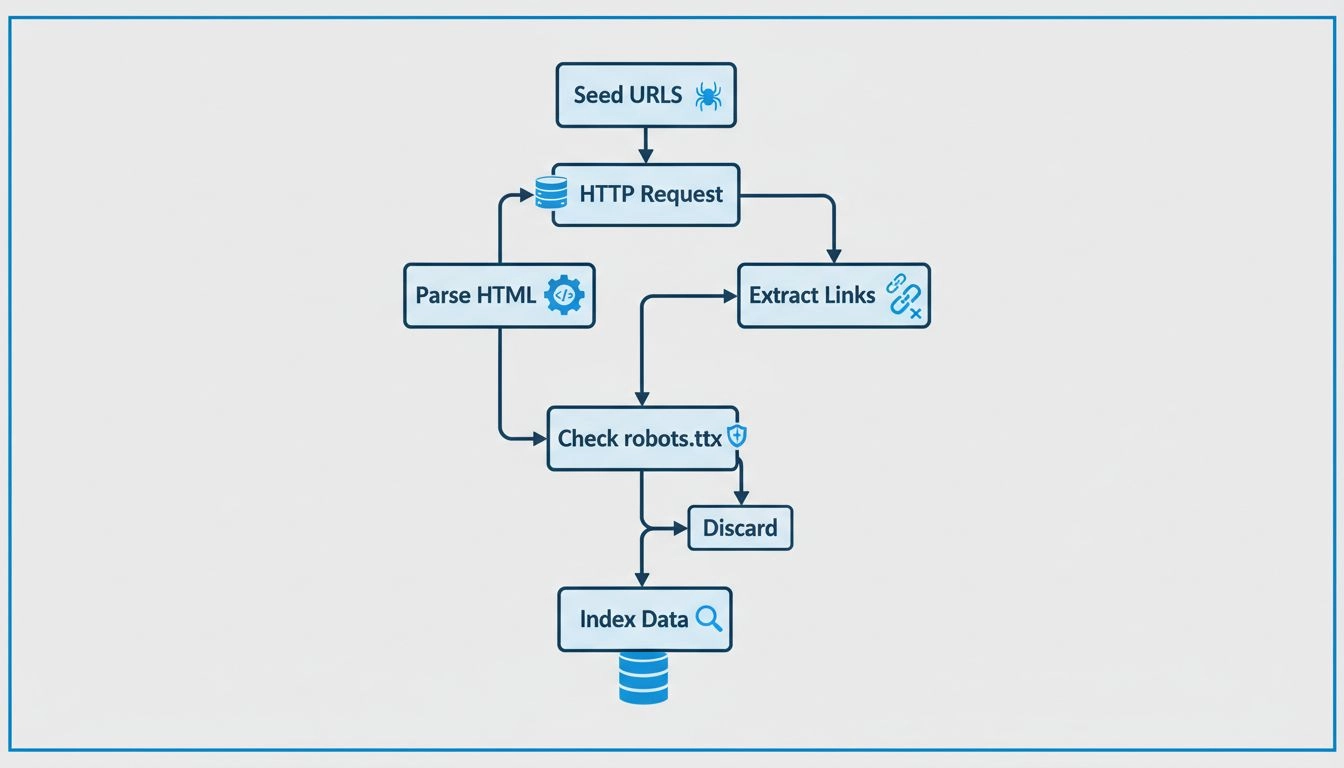
Scopri come funzionano i web crawler, dagli URL seed all'indicizzazione. Comprendi il processo tecnico, i tipi di crawler, le regole del robots.txt e come i cra...
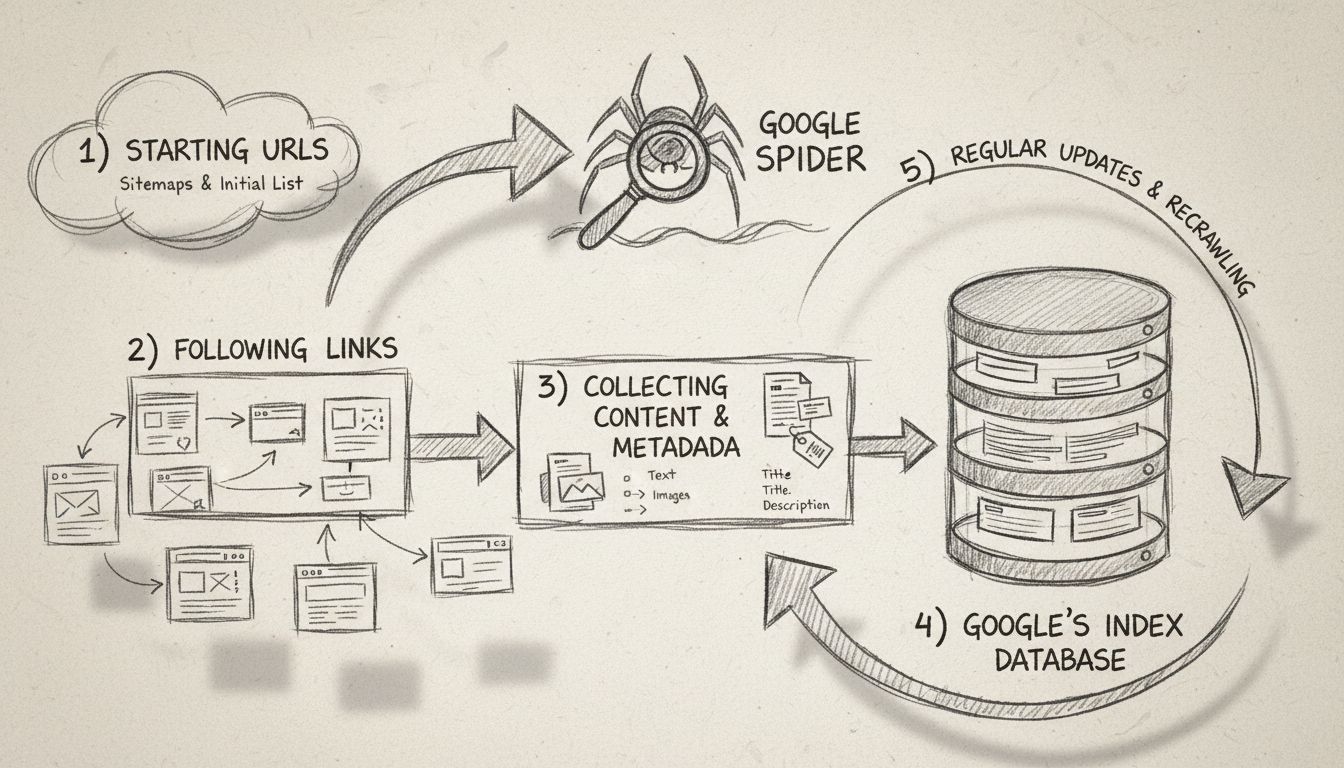
Scopri cos'è lo Spider di Google (Googlebot), come effettua il crawling e l'indicizzazione dei siti web e perché è fondamentale per la SEO. Impara come ottimizz...
Unisciti alla nostra community di clienti soddisfatti e fornisci un eccellente supporto clienti con PostAffiliatePro.


Consenso Cookie
Usiamo i cookie per migliorare la tua esperienza di navigazione e analizzare il nostro traffico. See our informativa sulla privacy.