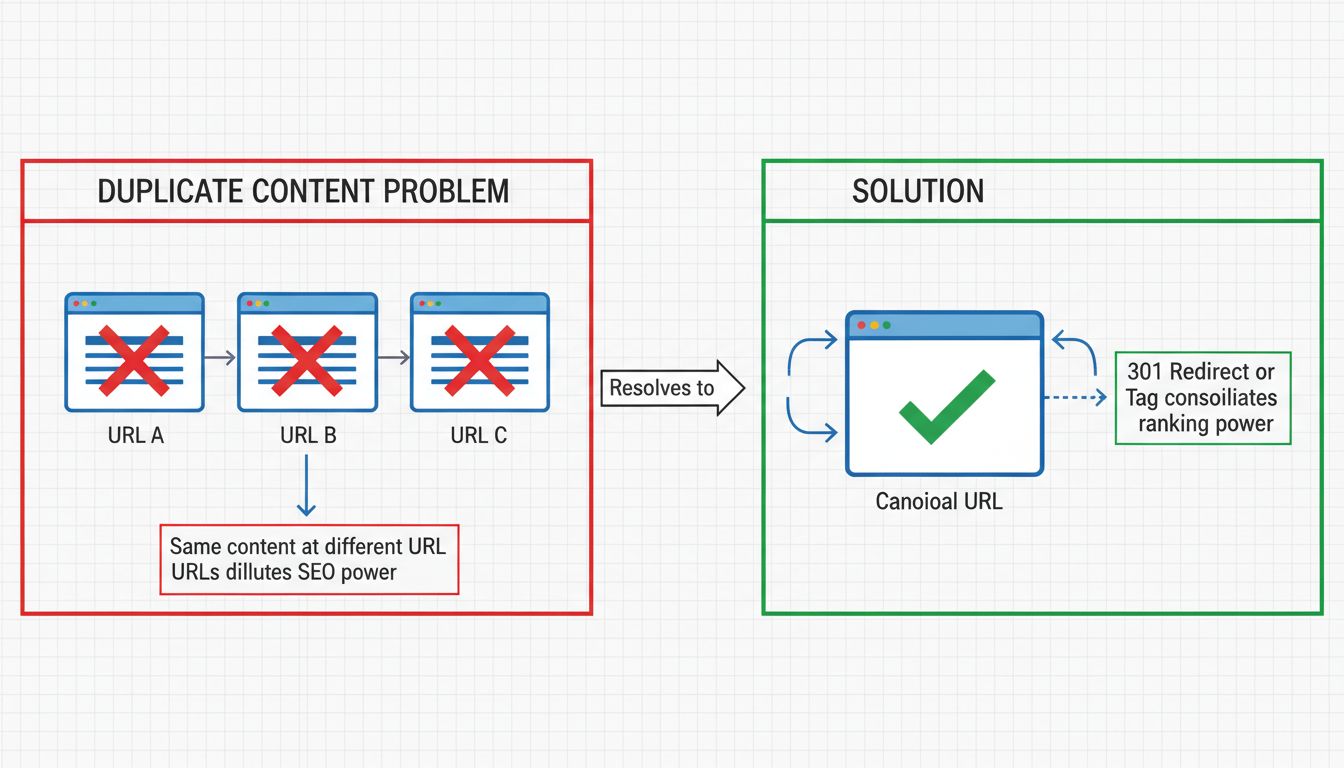
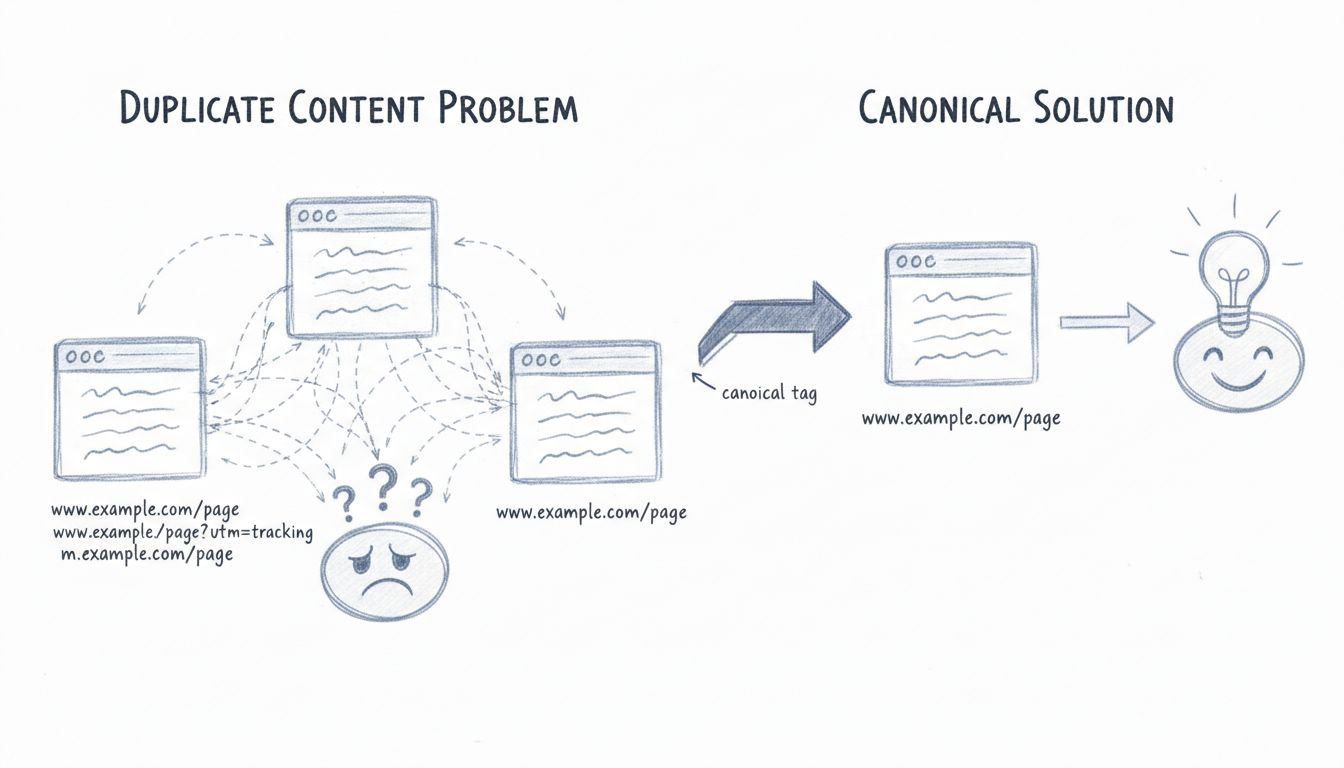
Il contenuto duplicato è blocchi sostanziali di testo, codice o media che appaiono in più di un posto su internet — ovvero due o più URL distinti che forniscono lo stesso materiale o materiale molto simile a utenti e motori di ricerca. Quando Google, Bing o qualsiasi altro crawler incontra lo stesso contenuto su più indirizzi web, deve decidere quale versione indicizzare, quale posizionare e quale ignorare. E quella decisione non è sempre quella che prenderesti tu.
Comprendere il contenuto duplicato è importante per chiunque gestisca un sito web, un programma di affiliazione o pubblichi contenuti online. Se non viene gestito, suddivide i segnali di ranking, spreca il crawl budget e confonde i motori di ricerca da cui dipendi per il traffico.
Cosa si intende per contenuto duplicato?
Il contenuto duplicato significa che lo stesso contenuto, o contenuto sostanzialmente simile, si trova su più URL. Questi URL possono appartenere allo stesso dominio (duplicazione interna) o a siti web completamente diversi (duplicazione esterna).
Una pagina è considerata duplicata quando presenta una sovrapposizione evidente nella formulazione, nella struttura e nel messaggio principale con un’altra pagina, aggiunge poche o nessuna informazione originale e non offre un valore significativo oltre a quanto già fornito dall’altra versione. Intestazioni, piè di pagina ed elementi di navigazione che si ripetono in tutto il sito non contano — i motori di ricerca capiscono che fanno parte di un template, non del contenuto sostanziale stesso.
Contenuto duplicato interno
La duplicazione interna avviene all’interno di un singolo dominio. Scenari comuni includono:
- Una pagina prodotto raggiungibile sia a
example.com/product che a example.com/product?color=blue - Le versioni HTTP e HTTPS della stessa pagina che restituiscono entrambe un codice di stato 200
- Varianti WWW e non-WWW entrambe accessibili e indicizzate
- Versioni stampabili degli articoli che generano URL separati
- Filtri di categoria e parametri di ordinamento che creano infinite combinazioni di URL sui siti e-commerce
Ognuno di questi crea un indirizzo separato per lo stesso contenuto sottostante. I motori di ricerca vedono più URL in competizione per la stessa query e raramente li premiano tutti.
Contenuto duplicato esterno
La duplicazione esterna si verifica quando il contenuto di un dominio appare su un altro. Può essere dannosa — contenuti scraped e ripubblicati senza autorizzazione — o del tutto legittima, come nel caso di articoli sindacati distribuiti a siti partner. Senza un tag canonico che punti all’originale, i motori di ricerca potrebbero posizionare la copia sopra la fonte, o suddividere i segnali di ranking tra entrambi.
Contenuto esatto vs. quasi duplicato
Non tutto il contenuto duplicato è identico. Il contenuto quasi duplicato condivide la stessa struttura e lo stesso messaggio principale ma varia in piccoli dettagli: una pagina prodotto in cui cambia solo il nome del colore, una pagina per area di servizio in cui cambia solo la città, o una versione tradotta dello stesso articolo. Google li tratta come duplicati quando le differenze sono troppo sottili per giustificare una pagina separata. La soglia non è una percentuale fissa — dipende dal fatto che ogni pagina fornisca un valore genuinamente distinto per l’utente.
Lancia il tuo programma di affiliazione oggi
Configura il tracciamento avanzato in pochi minuti. Nessuna carta di credito richiesta.
Perché il contenuto duplicato è importante?
Il contenuto duplicato crea tre problemi concreti per i motori di ricerca e i proprietari dei siti.
Confusione su quale versione indicizzare
Quando più URL forniscono lo stesso contenuto, i motori di ricerca devono sceglierne uno da memorizzare nel loro indice. Potrebbero scegliere quello sbagliato — un URL pieno di parametri non ottimizzato invece della versione canonica pulita. Le altre versioni potrebbero essere eliminate del tutto, il che significa che la pagina che desideri posizionare non apparirà mai nei risultati di ricerca.
Equità dei link diluita
I backlink sono tra i segnali di ranking più forti. Quando siti esterni linkano a diverse versioni dello stesso contenuto — alcuni alla versione HTTP, altri a HTTPS, alcuni con la barra finale e altri senza — l’autorità che quei link portano viene suddivisa tra più URL invece di concentrarsi su uno solo. Una pagina che avrebbe potuto posizionarsi al terzo posto potrebbe finire al dodicesimo perché la sua equità di link è frammentata tra quattro URL duplicati.
Crawl budget sprecato
I motori di ricerca allocano una quantità finita di tempo e risorse per la scansione di ogni sito. Ogni URL duplicato elaborato da un crawler è una pagina unica e di valore in meno che può scoprire e indicizzare in quella sessione. Su siti di grandi dimensioni — negozi e-commerce con migliaia di SKU, hub di contenuti affiliate con pagine generate dinamicamente — lo spreco di crawl budget dovuto ai duplicati può sopprimere la visibilità di pagine davvero importanti.
Google punisce il contenuto duplicato?
No — non nel senso di una penalità manuale. La maggior parte dei contenuti duplicati sul web è accidentale, non ingannevole, e i sistemi di Google ne tengono conto.
La distinzione è importante. Google interviene contro la duplicazione deliberatamente manipolativa: siti che scrapano e ripubblicano contenuti su larga scala esclusivamente per attirare traffico di ricerca, o che generano migliaia di doorway page quasi identiche piene di parole chiave. In questi casi, Google può applicare un’azione manuale o una soppressione algoritmica. Ma per il normale proprietario di un sito web con una manciata di URL duplicati generati da parametri, la conseguenza non è una penalità — è l’opportunità persa di segnali suddivisi e ranking diluiti.
Il risultato pratico è simile: il tuo contenuto ottiene prestazioni inferiori. Ma capire che si tratta di un effetto di filtraggio algoritmico piuttosto che di un provvedimento punitivo ti aiuta a prioritizzare correttamente gli interventi. Non stai correndo per evitare una penalità; stai consolidando una forza che è già tua.
Iscriviti alla nostra newsletter
Sii il primo a conoscere le nuove funzionalità e gli aggiornamenti del prodotto.
Cause comuni del contenuto duplicato
La maggior parte dei contenuti duplicati viene creata accidentalmente, dal modo in cui funzionano di default i sistemi di gestione dei contenuti, le piattaforme e-commerce e le architetture dei siti.
Parametri URL e ID di sessione
Parametri di tracciamento (?utm_source=, ?session_id=), opzioni di ordinamento (?sort=price) e combinazioni di filtri generano URL univoci per quella che è essenzialmente la stessa pagina. Una singola pagina prodotto su un sito e-commerce può generare decine di URL parametrizzati, ciascuno indicizzato separatamente se non gestito.
HTTP vs. HTTPS e WWW vs. non-WWW
Se il tuo sito è accessibile sia a http://example.com che a https://example.com, o sia a https://www.example.com che a https://example.com, hai almeno due versioni di ogni pagina. Senza un reindirizzamento a livello di sito da una all’altra, entrambe le versioni possono essere scansionate e indicizzate.
Variazioni di barra finale
example.com/pagina e example.com/pagina/ possono fornire lo stesso contenuto ma registrarsi come URL diversi. La maggior parte delle piattaforme CMS moderne gestisce automaticamente questa situazione, ma server mal configurati possono esporre entrambe le versioni.
Pagine versione stampabile e AMP
URL separati per versioni ottimizzate per la stampa o AMP degli articoli creano duplicati del contenuto principale. Se queste versioni alternative sono indicizzabili, competono con l’originale.
Contenuti scraped e sindacati
Quando altri siti copiano i tuoi contenuti — con o senza autorizzazione — creano duplicati esterni. Anche i partner di sindacazione legittimi hanno bisogno di tag canonici che puntino al tuo originale; altrimenti, la loro versione ripubblicata può superare la tua nei ranking.
Descrizioni di prodotto nell’e-commerce e nell’affiliate marketing
I produttori spesso forniscono la stessa descrizione di prodotto a centinaia di rivenditori e affiliati. Quando ogni venditore pubblica quel testo identico, i motori di ricerca vedono una massiccia duplicazione tra domini.
Navigazione facetata e pagine categoria filtrate
I siti e-commerce e di elenchi che permettono agli utenti di filtrare per dimensione, colore, fascia di prezzo o valutazione creano esplosioni combinatorie di URL. Una pagina categoria con cinque opzioni di filtro, ciascuna con cinque valori, può generare oltre 3.000 URL univoci — tutti che mostrano sostanzialmente la stessa griglia di prodotti.
Ambienti di staging e sviluppo
I siti di staging accidentalmente lasciati indicizzabili duplicano l’intero sito di produzione. Una configurazione errata di robots.txt o un tag noindex mancante su un server di sviluppo possono causare il mirroring completo del sito nei risultati di ricerca.
Come trovare il contenuto duplicato
Prima di poter risolvere il contenuto duplicato, devi sapere dove si trova. Diversi metodi e strumenti rendono questa operazione semplice.
Google Search Console
Questo è il modo più rapido e autorevole per individuare le duplicazioni che stanno già influenzando il tuo posizionamento.
Strumenti di audit del sito
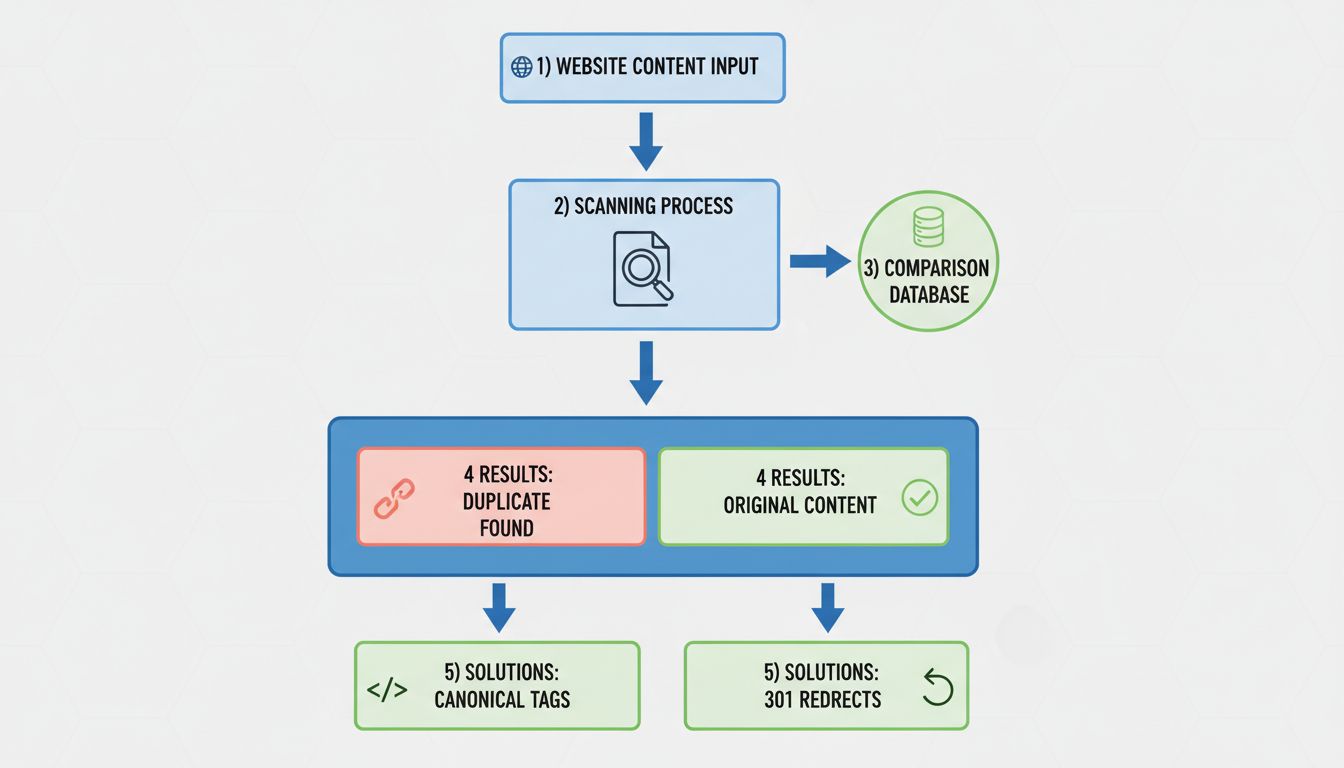
Crawler SEO dedicati — Screaming Frog, Sitebulb, Ahrefs Site Audit, Semrush Site Audit — scansionano l’intero sito e segnalano le pagine con titoli duplicati, meta description duplicate e contenuti del corpo quasi identici. Il report “Duplicate Pages” di Screaming Frog, ad esempio, raggruppa gli URL per hash del contenuto e mostra esattamente quali pagine condividono lo stesso contenuto o contenuti quasi identici. La maggior parte di questi strumenti offre piani gratuiti sufficienti per siti di piccole e medie dimensioni.
Ricerche di corrispondenza esatta
Copia una frase distintiva dal tuo contenuto — racchiusa tra virgolette — e incollala in Google. I risultati mostrano ogni pagina indicizzata che contiene quella frase esatta. Se vedi URL che non ti aspettavi, hai trovato duplicati esterni o pagine interne di cui non sapevi l’indicizzazione.
Strumenti anti-plagio
Strumenti come Copyscape e Siteliner confrontano i tuoi contenuti con il web in generale e con altre pagine del tuo stesso dominio. Copyscape è particolarmente utile per trovare siti che hanno scrapato i tuoi contenuti senza autorizzazione. Siteliner analizza le percentuali di duplicazione interna nel tuo dominio.
Controlli manuali per pattern comuni
Verifica se il tuo sito è accessibile con più varianti di protocollo e sottodominio. Apri http://tua-scelta.com, https://tua-scelta.com, http://www.tua-scelta.com e https://www.tua-scelta.com. Se più di uno si risolve in una pagina attiva invece di reindirizzare, hai un problema sistemico di contenuto duplicato che riguarda ogni pagina.
Come risolvere il contenuto duplicato
Risolvere il contenuto duplicato significa dire ai motori di ricerca quale versione di una pagina vuoi posizionare e consolidare tutti i segnali dietro di essa.
Reindirizzamenti 301
Un reindirizzamento 301 invia permanentemente utenti e motori di ricerca da un URL duplicato alla versione canonica. Questo è il segnale più forte che puoi inviare: consolida l’equità dei link, rimuove il duplicato dall’indice nel tempo e garantisce che i visitatori arrivino sempre alla pagina giusta.
Usa i reindirizzamenti 301 quando:
- Hai spostato o consolidato pagine in modo permanente
- Devi risolvere la duplicazione HTTP/HTTPS o WWW/non-WWW a livello di sito
- Un prodotto o articolo è stato sostituito da una versione più recente
- Stai unendo più pagine sottili in un’unica risorsa completa
Tag canonici (rel=“canonical”)
<link rel="canonical" href="https://example.com/pagina-originale/" />
I tag canonici sono lo strumento giusto quando:
- Devi mantenere le pagine duplicate accessibili agli utenti (ad esempio, viste di categoria filtrate, URL parametrizzati)
- Stai sindacando contenuti a siti partner e vuoi che il credito vada all’originale
- Più URL servono lo stesso contenuto per legittime ragioni di esperienza utente
A differenza di un reindirizzamento, un tag canonico non rimuove l’URL duplicato dall’esistenza — segnala solo una preferenza. I motori di ricerca lo trattano come un forte suggerimento, non come una direttiva assoluta.
Un tag noindex istruisce i motori di ricerca a non includere una pagina nel loro indice. Usalo su pagine che servono uno scopo per gli utenti ma non dovrebbero mai apparire nei risultati di ricerca: pagine di ringraziamento, pagine di risultati di ricerca interni, versioni stampabili e ambienti di staging.
<meta name="robots" content="noindex" />
Combina noindex con follow se vuoi comunque che l’equità dei link fluisca attraverso la pagina verso altre destinazioni.
Linking interno coerente
Ogni volta che linki a una pagina del tuo sito, usa esattamente lo stesso formato URL. Se la tua versione canonica è https://example.com/pagina/, non linkare a https://www.example.com/pagina o http://example.com/pagina/ nella navigazione, nei contenuti del corpo o nel piè di pagina. L’incoerenza nei tuoi stessi link invia segnali contrastanti che minano le tue scelte canoniche.
Gestione dei parametri URL in Google Search Console
Lo strumento Parametri URL di Google Search Console (in Strumenti legacy) ti permette di dire a Google come trattare parametri specifici. Puoi specificare che ?sort= o ?session_id= non modificano il contenuto della pagina, aiutando Google a consolidare gli URL parametrizzati sotto la versione canonica. Usalo con cautela — una configurazione errata può portare Google a ignorare parametri che invece producono contenuti significativamente diversi.
Creazione di contenuti unici
La soluzione più duratura al contenuto duplicato è creare pagine che siano genuinamente distinte. Per gli operatori di affiliate marketing, questo significa scrivere recensioni originali, confronti e guide invece di ripubblicare le descrizioni del produttore. Per i siti e-commerce, significa aggiungere fotografie uniche dei prodotti, domande e risposte dei clienti e guide all’acquisto originali. I motori di ricerca premiano i contenuti che aggiungono valore oltre a quanto già esiste altrove.
Contenuto duplicato nell’affiliate marketing
Gli operatori di affiliate marketing affrontano una sfida unica con il contenuto duplicato: promuovono prodotti che centinaia o migliaia di altri affiliati promuovono anch’essi, spesso utilizzando le stesse descrizioni, immagini e specifiche fornite dal produttore.
Il problema per gli affiliati
Quando un affiliato copia una descrizione di prodotto dal sito del merchant e la pubblica testualmente, entra a far parte di un pool di pagine identiche in competizione per le stesse parole chiave. Google vede decine o centinaia di pagine con lo stesso testo e deve sceglierne una — o nessuna — da posizionare. La pagina prodotto del merchant, con la sua maggiore autorità di dominio, vince quasi sempre. La pagina dell’affiliato sprofonda.
Non si tratta di una penalità. È un problema di pertinenza e autorità: il contenuto identico non aggiunge nulla di nuovo al web, quindi i motori di ricerca non hanno motivo di mostrare più copie.
Soluzioni pratiche per gli affiliati
Scrivi recensioni originali dei prodotti. Invece di ripetere l’elenco delle caratteristiche del produttore, descrivi la tua esperienza diretta con il prodotto. Cosa ti ha sorpreso? Cosa hai trovato frustrante? Come si confronta con alternative che hai testato? I dettagli di prima mano non possono essere duplicati da nessun altro.
Aggiungi valore unico oltre alla descrizione del prodotto. Includi fotografie originali, video dimostrativi, tabelle comparative create da te, scenari d’uso e risposte a domande che la pagina del produttore non affronta.
Usa tag canonici quando sindachi. Se pubblichi contenuti che appaiono anche sul sito del tuo merchant o su un blog partner, aggiungi un tag canonico che punti alla versione che desideri venga posizionata. Coordinati con il program manager del tuo programma di affiliazione per concordare quale URL è canonico.
Evita le strategie di doorway page. Creare decine di pagine quasi identiche che mirano a leggere variazioni di parole chiave — una volta una tattica comune tra gli affiliati — è esplicitamente contrario alle linee guida di Google e rischia la soppressione algoritmica. Una pagina completa che affronta un argomento in modo approfondito supererà dieci variazioni sottili.
Il ruolo del program manager
I program manager degli affiliati possono ridurre i problemi di contenuto duplicato nella loro rete di affiliazione:
- Incoraggiando gli affiliati a scrivere recensioni originali invece di copiare e incollare il testo fornito
- Fornendo indicazioni sui tag canonici in modo che gli affiliati sappiano a quale URL puntare quando utilizzano contenuti condivisi
- Monitorando le pagine degli affiliati più importanti per rilevare contenuti sottili o duplicati e offrendo feedback costruttivo
Il punto di vista dell’inserzionista
I merchant e gli inserzionisti che gestiscono programmi di affiliazione traggono vantaggio quando i loro affiliati pubblicano contenuti unici e di alta qualità. Questo amplia l’impronta di ricerca del marchio su più parole chiave e query di quanto il solo sito del merchant potrebbe catturare. Il contenuto duplicato da parte degli affiliati, al contrario, non aggiunge presenza incrementale nei risultati di ricerca e può creare un’impressione negativa del marchio quando gli utenti incontrano lo stesso testo su dozzine di siti di bassa qualità. Investire nella formazione degli affiliati e in asset creativi unici produce un dividendo SEO diretto.
Quanto contenuto duplicato è accettabile?
Non esiste una soglia percentuale ufficiale al di sotto della quale il contenuto duplicato sia “sicuro”. Google non utilizza un punteggio di duplicazione che innesca un’azione a un certo livello. Invece, la domanda è se ogni pagina fornisce un valore incrementale.
Lo standard pratico: se non ti sentiresti sicuro di spiegare a un utente perché questa pagina merita di esistere separatamente da pagine simili sul tuo sito o altrove, probabilmente è troppo sottile per giustificare un proprio URL.