

Perché la significatività statistica è importante?
Scopri perché la significatività statistica è fondamentale nell'analisi dei dati, nella ricerca e nelle decisioni aziendali. Approfondisci p-value, test d'ipote...
11 min di lettura
La significatività statistica è la probabilità che una relazione tra due o più variabili sia causata da qualcosa di diverso dal caso.
In questa pagina
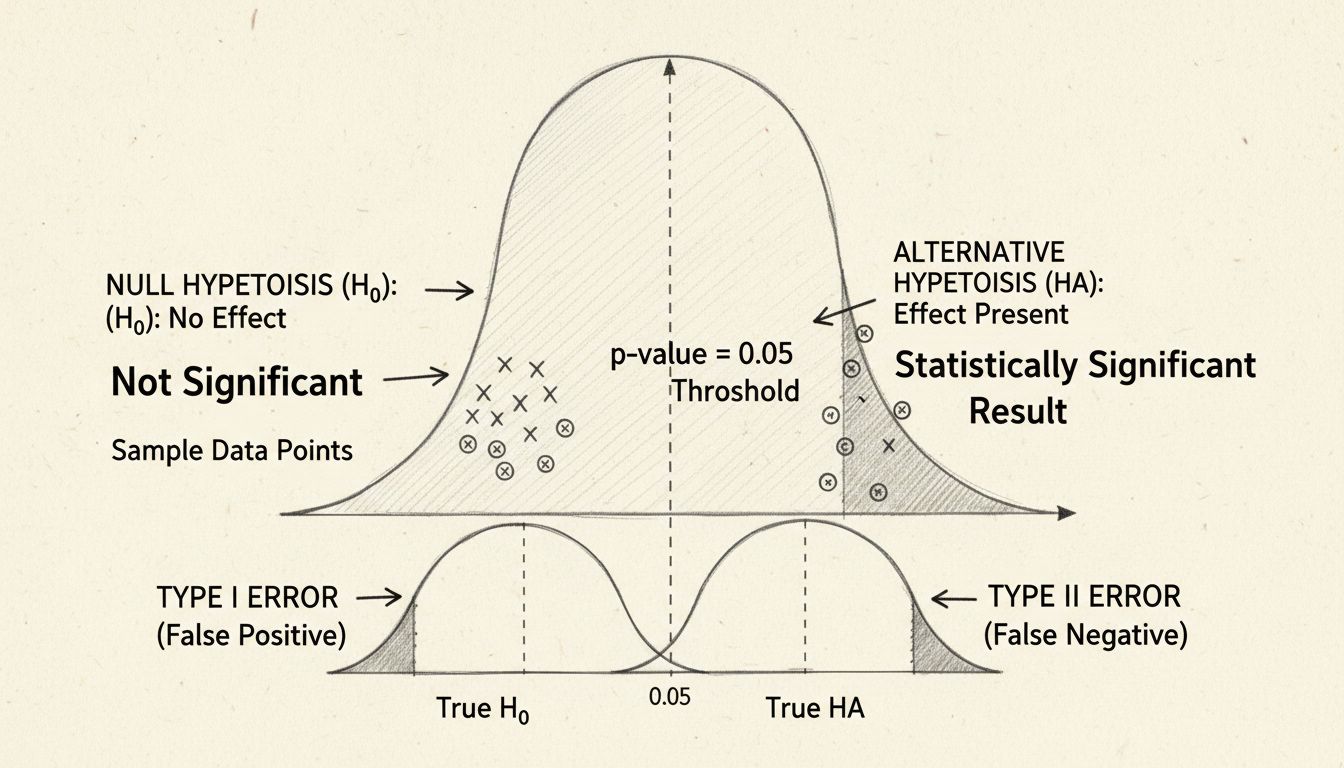
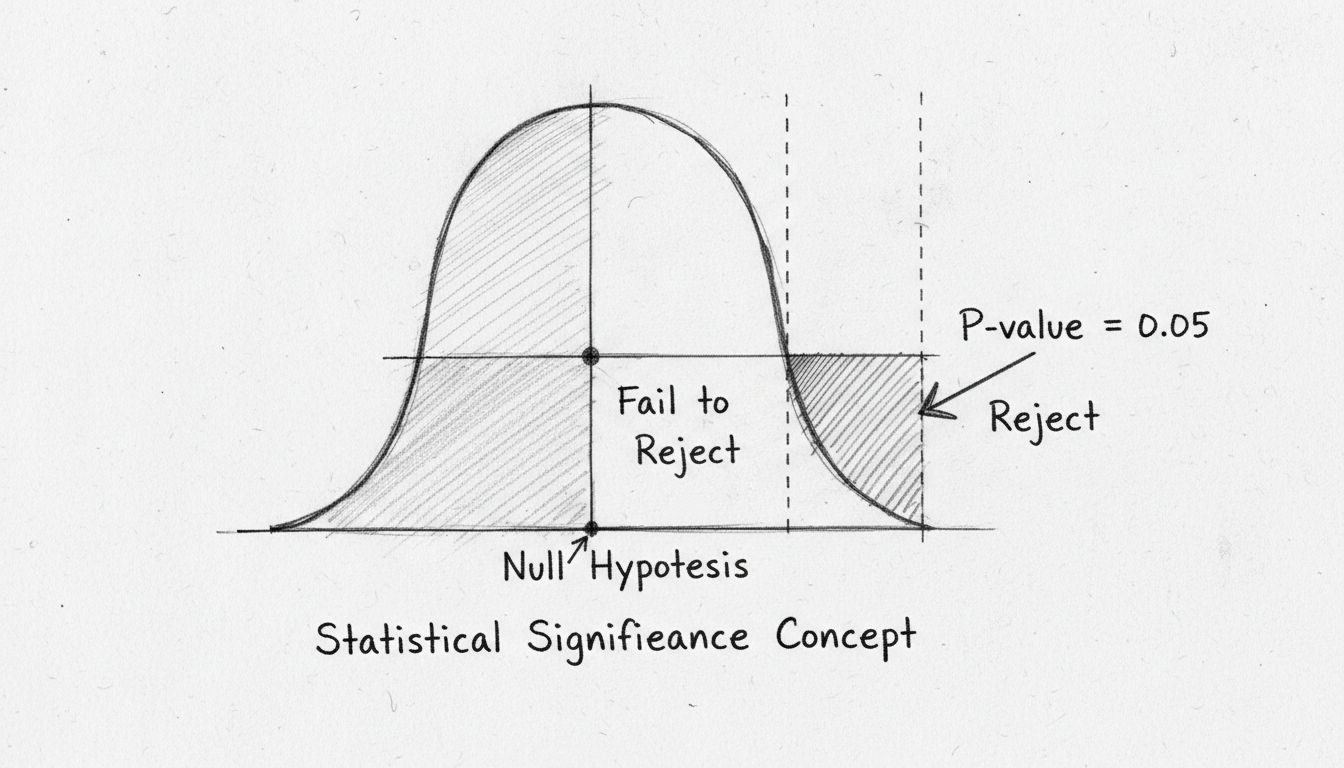
La significatività statistica è la probabilità che una relazione tra due o più variabili sia causata da qualcosa di diverso dal caso. In termini formali, è la probabilità che una differenza osservata — o una più estrema — si verifichi se l’ipotesi nulla (l’assunzione di nessun effetto reale) fosse vera.
Ogni set di dati contiene variazione casuale — la fluttuazione naturale che si verifica anche quando non esiste alcun effetto sottostante. Lancia una moneta equilibrata 100 volte, e raramente otterrai esattamente 50 teste. Quella deviazione è rumore casuale, non prova che la moneta sia truccata.
La significatività statistica quantifica se la deviazione che vedi è abbastanza grande, rispetto alla dimensione del tuo campione, da essere improbabile sotto il solo rumore casuale. Quando lo è, puoi rifiutare l’ipotesi nulla e concludere che probabilmente esiste un effetto reale.
Due concetti correlati aiutano qui:
Supponi di gestire un negozio online e testare due versioni di una pagina prodotto. La Versione A converte al 4,2%. La Versione B converte al 4,8%. Questa è una differenza di 0,6 punti percentuali — ma è reale?
Esegui un test statistico. Restituisce un valore p di 0,03.
Se il valore p fosse invece 0,30, lo stesso divario sarebbe del tutto coerente con il caso — e agire sulla base di esso sarebbe prematuro.

Configura il tracciamento avanzato in pochi minuti. Nessuna carta di credito richiesta.
Ogni test di significatività inizia con due affermazioni contrapposte:
Interpretazioni errate comuni da evitare:
Il livello di significatività, indicato con α (alpha), è la soglia che imposti prima di eseguire un test. Rappresenta la tua tolleranza per i falsi positivi — rifiutare l’ipotesi nulla quando è in realtà vera. Questo è anche chiamato errore di Tipo I.
| Soglia | Significato | Rischio di Falso Positivo |
|---|---|---|
| α = 0.05 | Standard nella maggior parte dei campi | 5% (1 su 20) |
| α = 0.01 | Più rigoroso; usato quando i falsi positivi sono costosi | 1% (1 su 100) |
| α = 0.001 | Molto rigoroso; decisioni ad alto rischio | 0.1% (1 su 1.000) |
Se p < α, il risultato è statisticamente significativo a quel livello.
Un intervallo di confidenza fornisce un intervallo di valori plausibili per la dimensione reale dell’effetto. Un intervallo di confidenza al 95% significa: se ripetessi lo studio 100 volte, circa 95 di quegli intervalli conterrebbero il valore reale.
Intervalli più stretti indicano stime più precise — tipicamente il risultato di dimensioni campionarie maggiori. Nei contesti aziendali, gli intervalli di confidenza sono spesso più informativi dei soli valori p perché mostrano l’entità e la direzione di un effetto, non solo se esiste.
Sì — nella maggior parte dei campi applicati, p < 0,05 è lo standard per rivendicare la significatività statistica. Questa convenzione risale al lavoro di Ronald Fisher negli anni ‘20 e, sebbene alquanto arbitraria, è persistita perché bilancia due rischi: falsi positivi (errori di Tipo I) e falsi negativi (errori di Tipo II, dove un effetto reale viene perso).
Un valore p di 0,01 è più significativo dal punto di vista statistico di 0,05 perché indica una probabilità inferiore che il risultato osservato sia dovuto al caso. Con α = 0,01, stai accettando solo un rischio dell'1% di falso positivo, rispetto al 5% con α = 0,05.
Tuttavia, un valore p più basso non significa automaticamente un effetto più grande o più importante. Con un campione enorme, anche una differenza trascurabilmente piccola può produrre p < 0,001. Ecco perché la dimensione dell’effetto e la significatività pratica devono essere valutate insieme al valore p.
Sii il primo a conoscere le nuove funzionalità e gli aggiornamenti del prodotto.
La dimensione del campione è il singolo fattore più influente. Campioni più grandi riducono l’impatto della variazione casuale, rendendo più facile rilevare le differenze reali. Ecco perché un aumento del 2% del tasso di conversione potrebbe essere significativo con 50.000 visitatori ma non con 500.
La dimensione dell’effetto misura l’entità della differenza osservata — non solo se esiste. Una dimensione dell’effetto grande (ad es., un aumento del 30% del tasso di conversione) raggiunge la significatività più velocemente e con campioni più piccoli. Una dimensione dell’effetto minima (ad es., 0,5%) richiede campioni enormi per essere rilevata in modo affidabile.
È qui che la relazione tra significatività statistica e significatività pratica diventa critica. Un risultato può essere statisticamente significativo ma praticamente irrilevante se l’effetto è troppo piccolo per avere importanza nelle decisioni aziendali.
Nessun test statistico può compensare dati di scarsa qualità. I problemi comuni di qualità dei dati includono:
Prima di calcolare la significatività statistica, verifica che la tua raccolta dati sia pulita, coerente e priva di distorsioni sistematiche. Un risultato significativo da dati errati è peggiore di nessun risultato.
La potenza statistica è la probabilità che un test rilevi un effetto reale quando esiste. È il complemento del tasso di errore di Tipo II (β).
La potenza dipende dalla dimensione del campione, dalla dimensione dell’effetto e dal livello di significatività scelto. Studi con potenza insufficiente sono un motivo comune per cui risultati apparentemente promettenti di test A/B non si replicano.
La significatività statistica è la probabilità che una relazione tra due o più variabili sia causata da qualcosa di diverso dal caso. In termini formali, è la probabilità che una differenza osservata — o una più estrema — si verifichi se l’ipotesi nulla (l’assunzione di nessun effetto reale) fosse vera.
Il quadro teorico proviene dal test di ipotesi, un ramo dell’analisi statistica sviluppato all’inizio del XX secolo da Ronald Fisher e perfezionato da Jerzy Neyman ed Egon Pearson.
Ogni set di dati contiene variazione casuale — la fluttuazione naturale che si verifica anche quando non esiste alcun effetto sottostante. Lancia una moneta equilibrata 100 volte, e raramente otterrai esattamente 50 teste. Quella deviazione è rumore casuale, non prova che la moneta sia truccata.
La significatività statistica quantifica se la deviazione che vedi è abbastanza grande, rispetto alla dimensione del tuo campione, da essere improbabile sotto il solo rumore casuale. Quando lo è, puoi rifiutare l’ipotesi nulla e concludere che probabilmente esiste un effetto reale.
Due concetti correlati aiutano qui:
Supponi di gestire un negozio online e testare due versioni di una pagina prodotto. La Versione A converte al 4,2%. La Versione B converte al 4,8%. Questa è una differenza di 0,6 punti percentuali — ma è reale?
Esegui un test statistico. Restituisce un valore p di 0,03.
Se il valore p fosse invece 0,30, lo stesso divario sarebbe del tutto coerente con il caso — e agire sulla base di esso sarebbe prematuro.
Ogni test di significatività inizia con due affermazioni contrapposte:
Il test non dimostra H₁ direttamente.
Questo quadro teorico si applica direttamente ai test A/B.
Interpretazioni errate comuni da evitare:
Il livello di significatività, indicato con α (alpha), è la soglia che imposti prima di eseguire un test. Rappresenta la tua tolleranza per i falsi positivi — rifiutare l’ipotesi nulla quando è in realtà vera. Questo è anche chiamato errore di Tipo I.
| Soglia | Significato | Rischio di Falso Positivo |
|---|---|---|
| α = 0.05 | Standard nella maggior parte dei campi | — |
| α = 0.01 | Più rigoroso; usato quando i falsi positivi sono costosi | — |
| α = 0.001 | Molto rigoroso; decisioni ad alto rischio | — |
Se p < α, il risultato è statisticamente significativo a quel livello.
Un intervallo di confidenza fornisce un intervallo di valori plausibili per la dimensione reale dell’effetto. Un intervallo di confidenza al 95% significa: se ripetessi lo studio 100 volte, circa 95 di quegli intervalli conterrebbero il valore reale.
Intervalli più stretti indicano stime più precise — tipicamente il risultato di dimensioni campionarie maggiori. Nei contesti aziendali, gli intervalli di confidenza sono spesso più informativi dei soli valori p perché mostrano l’entità e la direzione di un effetto, non solo se esiste.
Sì — nella maggior parte dei campi applicati, p < 0,05 è lo standard per rivendicare la significatività statistica. Questa convenzione risale al lavoro di Ronald Fisher negli anni ‘20 e, sebbene alquanto arbitraria, è persistita perché bilancia due rischi: falsi positivi (errori di Tipo I) e falsi negativi (errori di Tipo II, dove un effetto reale viene perso).
Un valore p di 0,01 è più significativo dal punto di vista statistico di 0,05 perché indica una probabilità inferiore che il risultato osservato sia dovuto al caso. Con α = 0,01, stai accettando solo un rischio dell'1% di falso positivo, rispetto al 5% con α = 0,05.
Tuttavia, un valore p più basso non significa automaticamente un effetto più grande o più importante. Con un campione enorme, anche una differenza trascurabilmente piccola può produrre p < 0,001. Ecco perché la dimensione dell’effetto e la significatività pratica devono essere valutate insieme al valore p.
Un valore p inferiore a 0,001 significa che il risultato osservato si verificherebbe per caso meno di 1 volta su 1.000 se l’ipotesi nulla fosse vera. Questa è una forte evidenza contro l’ipotesi nulla — ma non garantisce comunque l’importanza pratica.
La dimensione del campione è il singolo fattore più influente. Campioni più grandi riducono l’impatto della variazione casuale, rendendo più facile rilevare le differenze reali. Ecco perché un aumento del 2% del tasso di conversione potrebbe essere significativo con 50.000 visitatori ma non con 500.
Per i siti a basso traffico, ciò significa che i test devono durare più a lungo o puntare a cambiamenti con effetti più ampi.
La dimensione dell’effetto misura l’entità della differenza osservata — non solo se esiste. Una dimensione dell’effetto grande (ad es., un aumento del 30% del tasso di conversione) raggiunge la significatività più velocemente e con campioni più piccoli. Una dimensione dell’effetto minima (ad es., 0,5%) richiede campioni enormi per essere rilevata in modo affidabile.
È qui che la relazione tra significatività statistica e significatività pratica diventa critica. Un risultato può essere statisticamente significativo ma praticamente irrilevante se l’effetto è troppo piccolo per avere importanza nelle decisioni aziendali.
Nessun test statistico può compensare dati di scarsa qualità. I problemi comuni di qualità dei dati includono:
Prima di calcolare la significatività statistica, verifica che la tua raccolta dati sia pulita, coerente e priva di distorsioni sistematiche. Un risultato significativo da dati errati è peggiore di nessun risultato.
La potenza statistica è la probabilità che un test rilevi un effetto reale quando esiste. È il complemento del tasso di errore di Tipo II (β).
La potenza dipende dalla dimensione del campione, dalla dimensione dell’effetto e dal livello di significatività scelto. Studi con potenza insufficiente sono un motivo comune per cui risultati apparentemente promettenti di test A/B non si replicano.
Diversi tipi di dati richiedono test diversi:
| Test | Caso d’Uso | Esempio |
|---|---|---|
| Test T | Confronto delle medie di due gruppi | Tassi di conversione: Versione A vs. Versione B |
| Test Chi-quadro | Confronto delle frequenze categoriche | Tassi di click-through su più creatività pubblicitarie |
| Test Z | Confronto delle proporzioni con campioni grandi | Proporzioni di conversione delle landing page |
| ANOVA | Confronto delle medie tra tre o più gruppi | Performance su più partner affiliati |
Non è necessario calcolare la significatività statistica a mano. Gli strumenti più utilizzati includono:
La maggior parte degli strumenti riporta sia il valore p che l’intervallo di confidenza. Controlla sempre entrambi prima di prendere una decisione.
La significatività statistica non è solo un concetto accademico. Nel marketing affiliato, dove commissioni, budget e relazioni con i partner dipendono dai dati di performance, è una salvaguardia pratica contro errori di giudizio costosi.
Gli inserzionisti che gestiscono programmi di affiliazione testano regolarmente landing page, strutture di offerta e risorse creative. La significatività statistica garantisce che le decisioni su quale versione scalare siano basate su differenze reali di performance, non su fluttuazioni casuali.
Esempio di flusso di lavoro: Un inserzionista testa due strutture di commissioni — un tasso fisso del 10% vs. un modello a scaglioni 5%/12%/18%. Dopo 30 giorni e 5.000 transazioni, il modello a scaglioni mostra un valore medio dell’ordine superiore del 22%. Un test T restituisce p = 0,02. L’inserzionista può implementare con sicurezza la struttura a scaglioni, sapendo che la differenza osservata difficilmente è rumore casuale.
Senza test di significatività, l’inserzionista avrebbe potuto apportare la modifica basandosi su una fluttuazione a breve termine — e potenzialmente ridurre i guadagni dei partner se l’effetto si fosse invertito.
Gli editori (affiliati) prendono decisioni su quali prodotti promuovere, in quali fonti di traffico investire e quali formati di contenuti convertono meglio. Ciascuna di queste decisioni beneficia del test di significatività.
Esempio di flusso di lavoro: Un editore pubblica due versioni di un articolo di recensione — una con una tabella comparativa all’inizio, l’altra con la tabella alla fine. In 10.000 visualizzazioni di pagina, la versione con tabella all’inizio genera un tasso di click-through del 3,1% verso il merchant rispetto al 2,6% della versione con tabella alla fine. Un test Chi-quadro dà p = 0,04. L’editore adotta il formato con tabella all’inizio e applica lo schema ad altre recensioni.
I responsabili dei programmi valutano le performance dei partner, impostano gli scaglioni di commissione e decidono quali affiliati reclutare o mantenere. La significatività statistica aiuta a distinguere i performer costantemente elevati da quelli i cui mesi positivi sono solo varianza.
Esempio di flusso di lavoro: Un responsabile confronta due affiliati con volumi di traffico simili. L’affiliato A ha un tasso di conversione del 5,2% in 12 mesi; l’affiliato B ha il 4,1%. Un test Z a due campioni conferma che la differenza è significativa (p = 0,008). Il responsabile utilizza questi dati per assegnare commissioni di fascia più alta all’affiliato A e indagare su cosa l’affiliato B potrebbe migliorare.
In tutti e tre i ruoli, il principio è lo stesso: lascia che i dati raggiungano la significatività prima di agire. Decisioni premature — aumentare le commissioni per un partner che ha avuto un buon mese, o abbandonare una landing page che ha avuto una brutta settimana — sono tra gli errori più comuni ed evitabili nel marketing affiliato.
Questo è l’equivoco più persistente. Un risultato può essere statisticamente significativo con p < 0,001 e comunque essere troppo piccolo per avere importanza. In un noto esempio tratto dal manuale di statistica ingegneristica del NIST, un miglioramento del processo produttivo era statisticamente significativo ma produceva un guadagno di soli 0,2 unità — ben al di sotto della soglia di valore pratico.
Poniti sempre due domande:
Il P-hacking si riferisce alla pratica di eseguire multiple analisi e riportare selettivamente solo quelle che raggiungono la significatività. Le forme comuni includono:
Queste pratiche aumentano drasticamente i tassi di falsi positivi.
La lezione per gli utenti aziendali: pre-registra il tuo piano di test, attieniti a una metrica primaria e resisti alla tentazione di cercare la significatività.
La significatività statistica è meno utile — o decisamente fuorviante — in questi scenari:
Sfrutta la significatività statistica per ottimizzare le tue campagne, migliorare i tassi di conversione e prendere decisioni di marketing più intelligenti.
Scopri perché la significatività statistica è fondamentale nell'analisi dei dati, nella ricerca e nelle decisioni aziendali. Approfondisci p-value, test d'ipote...
Scopri come la significatività statistica determina se i risultati sono reali o dovuti al caso. Comprendi p-value, test delle ipotesi e applicazioni pratiche pe...
Padroneggia significatività statistica test A/B per betting: p-value, confidenza, campioni e ottimizzazione conversioni.
Unisciti alla nostra community di clienti soddisfatti e fornisci un eccellente supporto clienti con PostAffiliatePro.
Consenso Cookie
Usiamo i cookie per migliorare la tua esperienza di navigazione e analizzare il nostro traffico. See our privacy policy.