

Crawler dei motori di ricerca
Un crawler dei motori di ricerca è un bot automatizzato che esplora le pagine web per indicizzare i contenuti per motori come Google e Bing. Scopri come funzion...
12 min di lettura
SEO
DigitalMarketing
+3
Il rilevamento spider è il processo di identificazione dei programmi software automatizzati — chiamati spider, crawler web o bot — che visitano un sito web, determinando se ciascuno di essi ha uno scopo legittimo o rappresenta una minaccia per l’integrità dei dati, la spesa pubblicitaria o le entrate del programma affiliate.
Il rilevamento spider è il processo di identificazione dei programmi software automatizzati — chiamati spider, web crawler o bot — che visitano un sito web, e di determinazione se ciascuno di essi ha uno scopo legittimo o rappresenta una minaccia per l’integrità dei dati, la spesa pubblicitaria o le entrate del programma affiliate.
Il rilevamento spider è una disciplina di sicurezza e analisi che identifica i client HTTP automatizzati esaminando le loro firme tecniche, i pattern comportamentali e le caratteristiche di rete. Il termine “spider” deriva da come questi programmi esplorano il web — seguendo collegamenti ipertestuali da una pagina all’altra, come un ragno percorre la sua tela.
In pratica, il rilevamento spider risponde a una domanda per ogni visitatore: è un essere umano, un bot amichevole o uno script malintenzionato? La risposta determina se la visita viene conteggiata nelle tue analisi, se il click genera una commissione e se il lead entra nel tuo CRM.
I tre termini sono spesso usati in modo intercambiabile, ma hanno connotazioni diverse a seconda del contesto:
Non tutto il traffico automatizzato è ostile. Un rilevamento spider efficace distingue tra le categorie:
| Categoria di bot | Esempi | Dovresti bloccarli? |
|---|---|---|
| Crawler di motori di ricerca | Googlebot, Bingbot, YandexBot | No — bloccarli ti rimuove dai risultati di ricerca |
| Strumenti SEO e di marketing | AhrefsBot, SemrushBot, Moz Dotbot | Caso per caso — consumano risorse ma possono aiutare la visibilità |
| Monitoraggio e validazione | Crawler IAB Tech Lab, monitor di uptime | No — verificano ads.txt, SSL e salute del sito |
| Scraper di contenuti | Bot non identificati che copiano i tuoi contenuti | Sì — rubano contenuti e non offrono alcun valore |
| Bot per click fraud | Script che cliccano link affiliate o annunci | Sì — rubano direttamente dal tuo budget |
| Bot per frodi sui lead | Compilatori automatizzati di moduli che inviano iscrizioni false | Sì — sprecano la spesa CPA e inquinano il tuo CRM |
| Credential stuffer | Bot che testano credenziali di accesso rubate | Sì — rappresentano una minaccia per la sicurezza |
Il confine tra “buono” e “cattivo” non è sempre netto. Un crawler SEO proveniente da uno strumento legittimo può comunque distorcere le tue analisi se conteggi le sue visite come traffico umano. Il rilevamento spider ti fornisce i dati per prendere decisioni informate, non solo per bloccare tutto indiscriminatamente.

Configura il tracciamento avanzato in pochi minuti. Nessuna carta di credito richiesta.
Il rilevamento spider moderno combina più segnali. Nessun singolo controllo è affidabile da solo — i bot sofisticati falsificano gli user-agent, ruotano gli IP e imitano il comportamento umano. Un rilevamento efficace combina diversi metodi insieme.
Ogni richiesta HTTP include un’intestazione User-Agent che identifica il client che effettua la richiesta. I crawler legittimi si dichiarano apertamente:
Mozilla/5.0 (compatible; Googlebot/2.1; +http://www.google.com/bot.html)
Mozilla/5.0 (compatible; Bingbot/2.0; +http://www.bing.com/bingbot.htm)
Limite: Qualsiasi bot può dichiararsi Googlebot copiando la sua stringa user-agent. L’analisi dello user-agent è un filtro di primo passaggio, non un controllo conclusivo.
Il metodo affidabile per verificare l’identità dichiarata di un crawler è incrociare il suo indirizzo IP. Per i principali motori di ricerca, il processo funziona così:
*.googlebot.com per Googlebot).Se tutti e quattro i passaggi corrispondono, il crawler è autentico. Google, Bing e Yandex pubblicano tutti i loro intervalli IP e metodi di verifica. Qualsiasi bot che dichiari di essere Googlebot ma si connetta da un IP di un datacenter AWS viene immediatamente segnalato.
Gli esseri umani navigano in modo imprevedibile. Fanno pause tra le visualizzazioni delle pagine, scorrono a velocità variabili e cliccano in pattern difficili da replicare programmaticamente. I bot lasciano impronte diverse:
I segnali comportamentali sono più difficili da falsificare rispetto alle intestazioni o agli IP. Richiedono che l’operatore del bot simuli l’interazione umana, il che aumenta il costo e la complessità dell’attacco abbastanza da scoraggiare molti truffatori.
Il fingerprinting del dispositivo raccoglie attributi del client connesso — versione del browser, caratteri installati, risoluzione dello schermo, renderer WebGL e decine di altri segnali — per creare un identificatore univoco. Quando la stessa impronta appare in centinaia di “diversi” visitatori, o quando un’impronta non corrisponde allo user-agent dichiarato, i sistemi di rilevamento spider segnalano il traffico.
| Metodo | Cosa controlla | Punto di forza | Punto debole |
|---|---|---|---|
| Analisi user-agent | Stringa identificativa del browser/client | Filtro rapido a costo zero | Facilmente falsificabile |
| Verifica IP/DNS inverso | Origine di rete e corrispondenza nome host | Conclusivo per crawler noti | Funziona solo per bot dichiarati |
| Analisi comportamentale | Tempistiche richieste, pattern di navigazione | Difficile da falsificare su larga scala | Richiede dati di sessione |
| Fingerprinting del dispositivo | Attributi browser e hardware | Forte segnale antifrode | Potrebbero applicarsi normative sulla privacy |
| Sfide JavaScript | Capacità di eseguire script | Blocca script semplici | I crawler legittimi potrebbero non eseguire JS |
| Trappole honeypot | Link nascosti che solo i bot seguono | Rilevamento bot ad alta affidabilità | Richiede strumentazione del sito |
I programmi affiliate pagano i partner in base alle performance — click, lead o vendite. Ogni evento fraudolento conteggiato come legittimo costa denaro reale. Il rilevamento spider è la prima linea di difesa contro diverse categorie di frodi affiliate.
Il click fraud è l’attacco più diretto ai budget affiliate. Un bot simula click su link affiliate, gonfiando le metriche dei click senza alcun coinvolgimento umano. L’affiliate viene pagato per traffico che non ha mai avuto possibilità di conversione.
Il rilevamento spider individua il click fraud identificando i pattern automatizzati alla base dei click: IP di datacenter, click ripetuti da impronte digitali identiche e velocità di click che nessun essere umano potrebbe produrre.
Nei programmi affiliate a costo per lead (CPL), i bot inviano moduli di iscrizione falsi per attivare il pagamento delle commissioni. Questi lead sembrano reali a prima vista — hanno nomi, indirizzi email e numeri di telefono — ma non si convertono mai ulteriormente.
Il rilevamento spider segnala i lead falsi controllando se l’invio proviene da un IP di datacenter, un dispositivo falsificato o un dominio email usa-e-getta — segnali che un utente umano produrrebbe raramente.
Il cookie stuffing è una forma più subdola di frode. Uno script inserisce cookie di tracciamento affiliate nel browser di un utente all’insaputa di quest’ultimo — spesso tramite un pop-under, un’immagine 1×1 pixel o uno script iniettato in una pagina compromessa. Quando quell’utente effettua successivamente un acquisto, il truffatore rivendica la commissione.
Il rilevamento spider identifica gli script automatizzati che eseguono il cookie stuffing tramite la loro firma comportamentale: richieste rapide e invisibili che impostano cookie senza alcuna corrispondente visita alla pagina o interazione dell’utente.
Oltre alla perdita finanziaria diretta, il traffico bot corrompe ogni metrica su cui fai affidamento. I tassi di conversione calano perché il traffico bot gonfia il denominatore. Le performance delle campagne diventano illeggibili. I team di marketing ottimizzano verso coorti che non sono mai esistite.
Un rilevamento spider pulito ripristina la fiducia nei tuoi dati. Quando filtri il traffico bot prima che raggiunga le tue analisi, vedi ciò che i tuoi utenti umani fanno realmente — e puoi prendere decisioni basate sulla realtà.
Sii il primo a conoscere le nuove funzionalità e gli aggiornamenti del prodotto.
L’Interactive Advertising Bureau (IAB) Tech Lab mantiene il riferimento standard del settore per il rilevamento spider: l’IAB/ABC International Spiders and Bots List. È il fondamento su cui si basano la maggior parte dei sistemi seri di prevenzione delle frodi.
L’elenco è composto da due file di testo aggiornati regolarmente:
L’IAB prescrive un approccio in due fasi definito nelle sue linee guida per la misurazione delle impressioni pubblicitarie:
Questo metodo a doppio passaggio è lo standard per il rilevamento del traffico non valido (IVT) accreditato MRC. Garantisce che i crawler dichiarati vengano filtrati, mentre i bot sconosciuti non passino inosservati semplicemente perché non presenti in nessun elenco.
L’accesso richiede un accordo di abbonamento dati firmato e viene fornito tramite il portale Tech Lab Tools. Un account di accesso per azienda abbonata. Per la maggior parte dei responsabili di programmi affiliate, l’elenco viene consultato indirettamente — attraverso la piattaforma di rilevamento frodi o lo strumento analitico che già utilizzano, che concede la licenza dell’elenco per loro conto.
Questi sistemi integrati filtrano automaticamente il traffico bot dai tuoi report, quindi i click e le conversioni attribuiti a crawler noti non entrano mai nei tuoi calcoli di commissione.
Il vantaggio del rilevamento a livello di piattaforma è che non richiede configurazione — funziona immediatamente, gestito dal fornitore, con l’elenco IAB integrato.
Per i programmi con una maggiore esposizione alle frodi — pagamenti CPA elevati, volumi di traffico alti o settori presi di mira da organizzazioni fraudolente — le piattaforme dedicate di prevenzione frodi aggiungono livelli oltre al rilevamento spider di base:
Anche senza una piattaforma dedicata, i responsabili di programma possono monitorare manualmente diversi segnali:
Una spider trap è un insieme di pagine generate dinamicamente che creano un ciclo infinito per i web crawler. Esempi comuni includono:
Un crawler legittimo che incontra una spider trap può bruciare il suo crawl budget — il numero di pagine che alloca al tuo sito — indicizzando migliaia di pagine quasi identiche mentre perde i tuoi contenuti reali.
Le spider trap danneggiano il tuo sito in due modi. Primo, sprecano il crawl budget: Googlebot spende la sua allocazione su URL senza senso invece che sulle tue pagine prodotto e articoli del blog. Secondo, possono degradare le prestazioni del server mentre i crawler colpiscono pagine generate dinamicamente.
La soluzione è semplice: usa robots.txt per impedire la scansione di pattern URL soggetti a trappole, aggiungi tag rel="canonical" per consolidare pagine duplicate ed evita di esporre spazi URL infiniti attraverso collegamenti interni. I sistemi di rilevamento spider possono anche identificare quando un crawler noto è bloccato in una trappola e limitare il suo accesso di conseguenza.
Salvaguarda le tue campagne affiliate e l'integrità dei dati con strumenti avanzati di rilevamento spider e strategie di prevenzione delle frodi.
Un crawler dei motori di ricerca è un bot automatizzato che esplora le pagine web per indicizzare i contenuti per motori come Google e Bing. Scopri come funzion...
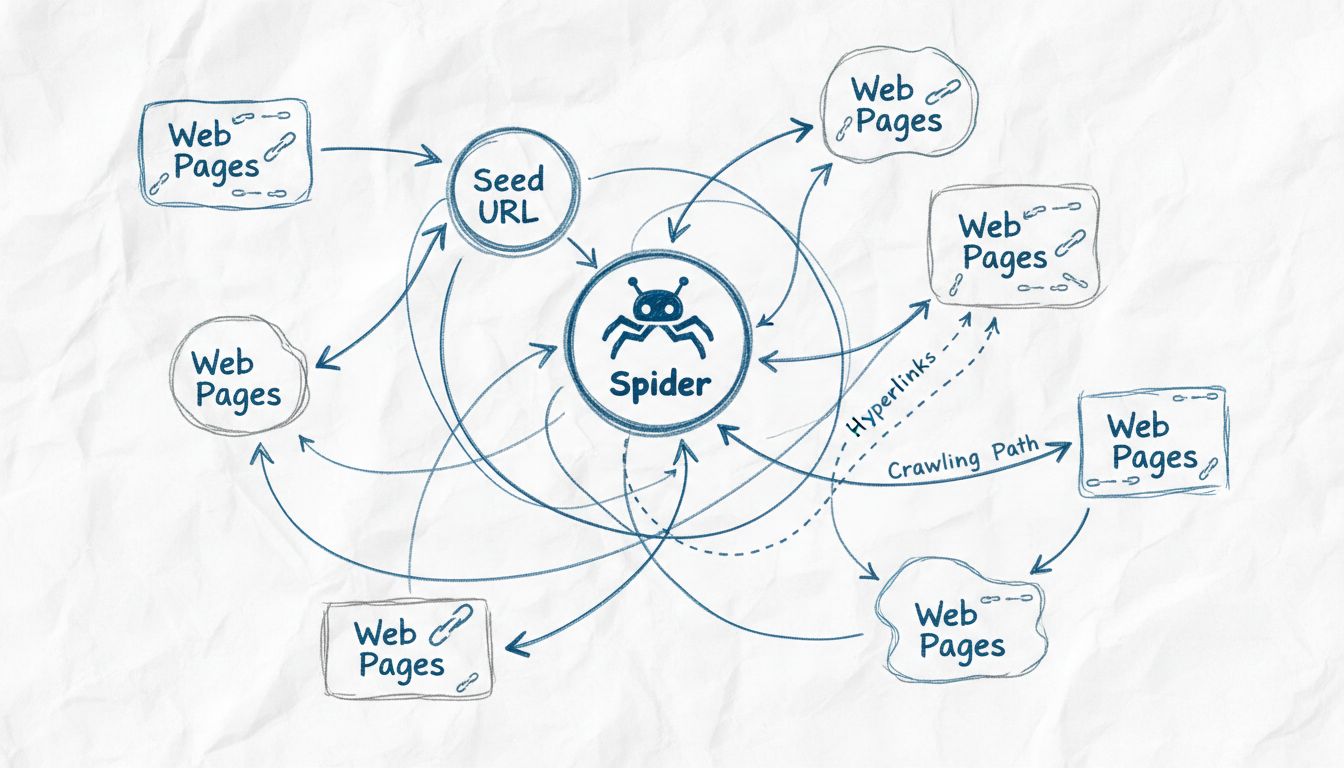
Scopri perché i web crawler sono chiamati spider, come funzionano e il loro ruolo fondamentale nell'indicizzazione dei motori di ricerca. Esplora i meccanismi t...
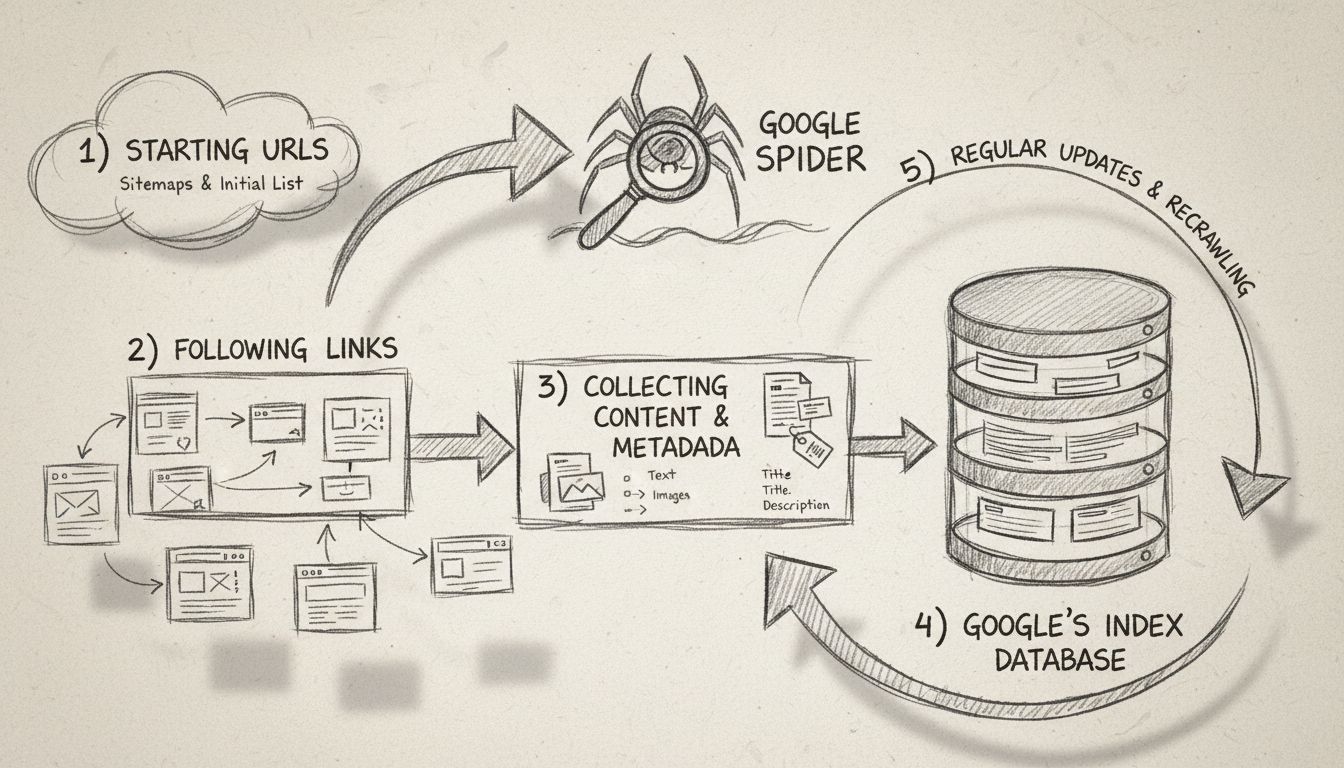
Scopri cos'è lo Spider di Google (Googlebot), come effettua il crawling e l'indicizzazione dei siti web e perché è fondamentale per la SEO. Impara come ottimizz...
Unisciti alla nostra community di clienti soddisfatti e fornisci un eccellente supporto clienti con PostAffiliatePro.
Consenso Cookie
Usiamo i cookie per migliorare la tua esperienza di navigazione e analizzare il nostro traffico. See our privacy policy.